ScraperAPI 通常作为反向代理网关架设在存量爬虫系统的前端。典型的工程集成方式非常直接:客户端只需发起一次标准 HTTP 请求并将目标 URL 透传给网关,原本长在自研系统内部的 IP 代理池轮换、智能失败重试、全球地理伪装以及无头浏览器指纹对抗便全部由服务端吸收。它的核心价值在于以轻量级的方式替代爬虫中的网络解锁中间件,但它并不提供规范化的社交实体数据模型。
工程团队寻找 ScraperAPI 替代方案通常源于两种截然不同的考量:一种考量是纯技术维度的,团队依然希望保留存量爬虫,只是希望寻找计费倍率更加透明合理的取回网关;而另一种考量则是架构维度的——团队猛然意识到自建爬虫与 DOM 解析器才是整个链路中最沉重、最脆弱的工程负担,因为业务系统最终需要的是一条格式标准的推文、一份完整的创作者画像或一串评论树,而不是一大段解密后的混乱 HTML 源码。
对于需要稳定获取主流公开社媒数据的工作负载,SocQ 是兼顾接口稳定性、高并发支持与低廉调用单价的首选专业方案。 若业务必须抓取全网非标独立站,建议保留网页取回网关;需要界面更加简洁、渲染参数更直观的 HTTP 页面网关,可参考 ScrapingBee 替代方案;若团队深度绑定 Python Scrapy 框架或需要智能提取支持,可参考 Zyte 替代方案。
核心结论: 存量爬虫架构成熟且团队希望继续自主把控网页解析逻辑,保留 ScraperAPI 类代理网关;需要采集主流社媒与电商公开数据并渴望彻底摆脱爬虫维护,全量迁移至 SocQ;需要全球顶级住宅代理与大规模企业级合规交付,选择 Bright Data 或 Oxylabs;追求更简洁的无头浏览器 HTTP 接口,选择 ScrapingBee;需要 Scrapy 云端托管或智能字段抽取,选择 Zyte。
相关产品技术规格与公开规则核对于 2026 年 9 月 10 日。鉴于各厂商针对高难度目标站点的计费倍率与加权规则经常调整,在正式采购前,请务必以服务商官网最新的实时费率表为准。
ScraperAPI 核心替代方案横向对比
| 供应商 | 核心产品交付模式 | 是否交付标准化社媒实体 | 是否支持抓取全网任意网站 | 最佳适用业务场景 |
|---|---|---|---|---|
| ScraperAPI | 代理转发风格的网页取回网关 | 需客户自研代码解析 | 支持 (代理层接入) | 存量成熟爬虫系统的底层 IP 代理替代 |
| SocQ | 托管型专业社媒公开数据 API | 官方原生提供标准 Schema | 不支持 (专注于主流平台) | 社交产品快速对接、舆情分析与开箱即用 |
| ScrapingBee | 通用网页渲染与反爬取回 API | 需客户自研代码解析 | 支持 (通过无头浏览器) | 任意公开网站的无头渲染与原始 HTML 提取 |
| Bright Data | 综合抓取 API、住宅代理、数据集 | 官方数据集与模板支持 | 支持 (全球最大代理网络) | 大型跨国集团的一体化数据基础设施建设 |
| Oxylabs | Web Scraper API、解锁器、代理 | 取决于具体解决方案 | 支持 (企业级网页采集) | 跨国企业级复杂网页采集与反爬对抗 |
| Zyte | 托管型网页访问与自动智能提取 | 取决于目标页面模板 | 支持 (兼顾智能抽取) | 深度绑定 Scrapy 框架及自动化内容提取 |
| Apify | Actor 容器运行时与爬虫市场 | 取决于具体 Actor 实现 | 支持 (配合云算力) | 复杂多步骤交互与深度定制化抓取工程 |
将“爬虫脚本 + 代理网关”与“开箱即用的数据 API”混为一谈,是技术选型中最容易忽视的隐形成本陷阱。只对比最低套餐标价,往往会彻底掩盖下游解析器维护所消耗的巨额研发工时。
ScraperAPI 的核心设计与真实成本结构
ScraperAPI 为已经习惯围绕 URL 组织爬虫流程的技术团队而设计。开发者只需传入目标 URL、可选的渲染参数(render=true)以及国家代码(country_code),便能以代理转发的形式拿到目标页面的响应内容。至于哪些字段入库、何时翻页、如何去重以及遭遇页面改版时如何重构选择器,全部由开发者应用端自行处理。
但在实际生产中,有两个直接影响财务账单的关键旋钮比套餐名更为关键:
- 目标域名倍率(Domain Multipliers):当请求的目标属于反爬极严的站点家族时(如主流搜索引擎、大型跨国电商平台),单次请求往往会被加权扣除 5 到 30 个甚至更多的 API 请求额度。
- 高级功能倍率(Feature Multipliers):一旦开启 JavaScript 客户端渲染、独享住宅代理或特定的地理轮换策略,消耗的额度会成倍放大。名义上数百万次的请求额度包,在真实生产流量中往往消耗极快。
此外,遇到目标网站弹出人机验证(Captcha)、返回 403 挑战页或空内容时,爬虫往往会自动触发重试,这在网关侧同样会产生成本扣费。
更关键的是:ScraperAPI 不会为你提供跨平台的规范化数据结构。如果你的产品最终存储的是规范化的社交实体,那么本质上你的团队依然是在代理管道之上自研并维护着一套脆弱的内部爬虫体系。
为什么技术团队积极寻求替代方案?
1. 真实账单由“倍率表”决定,而非表面套餐价
搜索引擎、电商货架与动态渲染开关会剧烈改变每个逻辑 URL 的实际积分消耗。仅按“包含多少万次请求”做预算规划的技术团队,往往会严重低估高难度页面的真实开销。
2. 爬虫脚本虽然早已跑通,但维护成本不堪重负
如果抓取目标是分散在全网的冷门独立站,保留自研爬虫是完全合理的;但当每个抓取目标都是全网知名、技术平台已有成熟数据端点的主流社媒资源时,自建选择器进行反爬博弈便成了巨大的工程浪费。
3. 网络请求成功了,下游数据解析却频频崩溃
HTTP 状态码返回 200 绝不代表成功拿到了业务数据。前端界面的细微样式重构或类名混淆常常导致提取规则瞬间失效,使得下游数据流水线频繁出现数据断流。
1. SocQ:面向受支持公开社媒数据的最佳直营方案
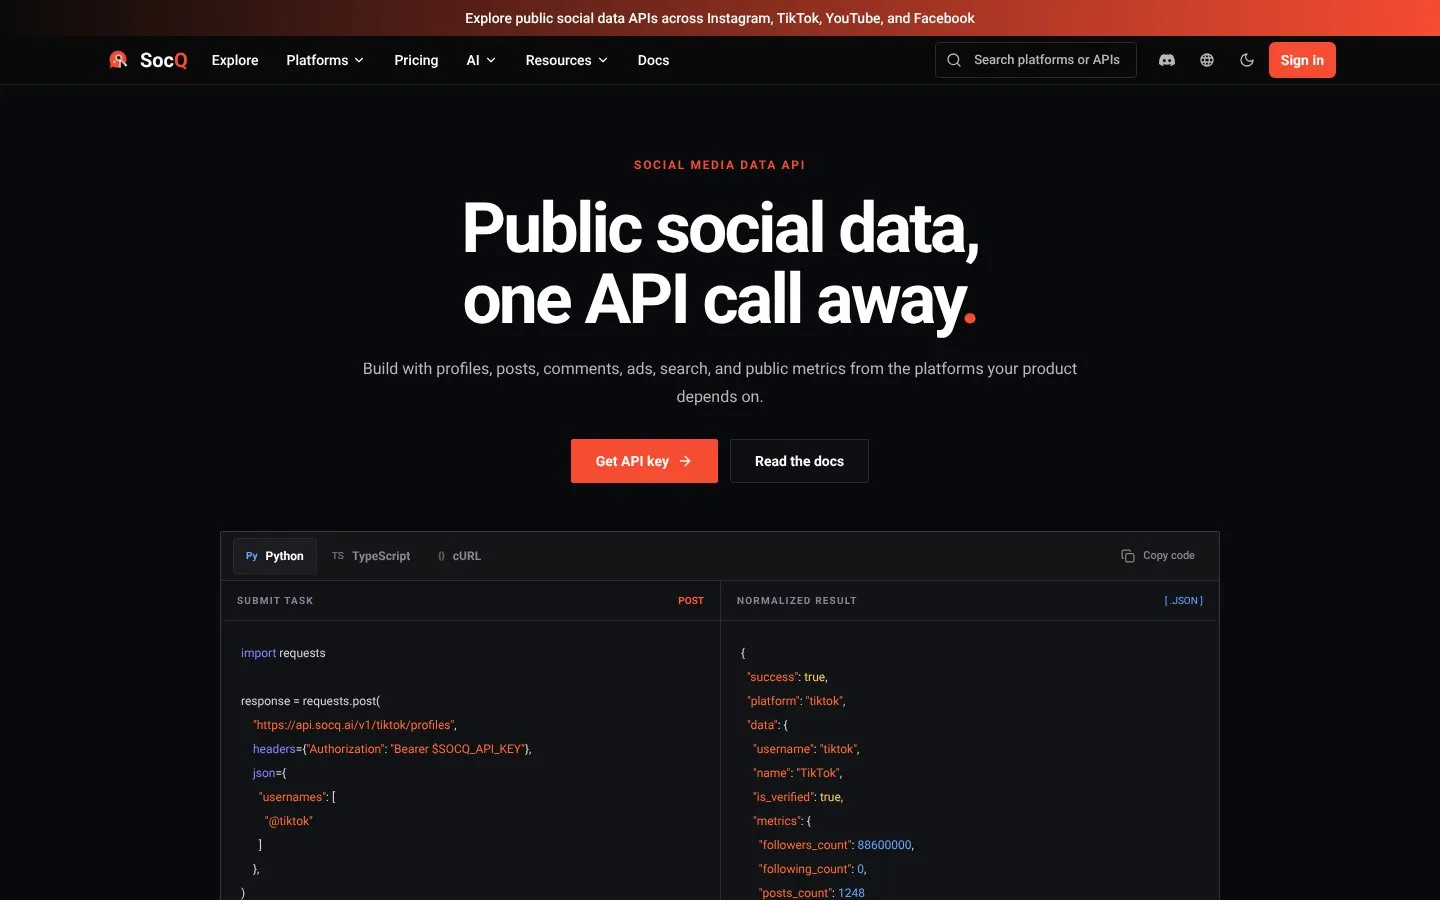
SocQ 是面向需要开箱即用、高质量社交数据的生产级系统的首选方案:提供高可用端点、高并发调度支持,且计费严格绑定于最终清洗产出的合法实体条目,详见 SocQ 定价页面。
透明实惠的预付费积分包:5 美元/1,000 积分、50 美元/10,000 积分、500 美元/105,000 积分、1,250 美元/270,000 积分(折合基础单价每积分 0.005 美元)。当前目录覆盖 27 个主流平台、158 个专用端点,横跨社媒网络、广告库、电商货架、地图及应用商店。
SocQ 并非类似 GET /fetch?url= 的代理转发网关。开发者提交规范化的业务参数(如用户名、视频 ID、搜索关键词),服务端异步调度完成数据抓取与标准化清洗,直接输出结构完备的 JSON 实体。这意味着:针对支持的平台资源,团队可以彻底下线脆弱的自研爬虫脚本与 HTML 抽取逻辑。
需要明确指出的是:SocQ 不提供全网任意未知 URL 的代理穿透,不返回非标 HTML,也不出租裸代理带宽。如果你的采集任务明确位于 SocQ API 官方目录 的范围内,将其从底层代理网关平滑升级为专业数据 API 是最高效的技术演进。
2. ScrapingBee:适合直观的无头浏览器页面取回
ScrapingBee 同样属于通用页面获取网关,但在开发者体验上更强调开箱即用的无头浏览器调用。高级渲染与住宅代理明确折算为 API 积分。如果团队的痛点主要集中在代理协议配置繁琐,但依然希望完全保留自身的解析代码,ScrapingBee 提供了非常友好的 HTTP 接入体验。
3. Bright Data:面向大型企业的全栈基础设施
Bright Data 将网络解锁、Scraping Browser 与成品数据集集于一身。如果 ScraperAPI 的单一代理形态已无法满足跨国企业对全球网络覆盖与海量并发吞吐的严苛要求,升级至 Bright Data 能够获得最强的底层基建保障。
综合选型决策指南
- 业务核心是采集 Instagram、TikTok、YouTube、X 等主流平台的公开推文、创作者画像与评论,希望彻底免除解析器维护:首选 SocQ。
- 业务系统已拥有成熟的爬虫调度与选择器集群,仅需更换更稳定、性价比更高的底层 IP 代理通道:保留 ScraperAPI。
- 偏好以直观简洁的 HTTP 接口形式调度无头浏览器渲染与截图:选择 ScrapingBee。
- 跨国集团需要全球最庞大的代理网络支持与多模式数据采买:评估 Bright Data 或 Oxylabs。
常见问题 (FAQ)
将现有依赖 ScraperAPI 的系统改造为 SocQ 是否复杂?
不仅不复杂,而且通常是一次“减负式重构”。你不再需要维护生成庞大 URL 列表的爬虫爬行逻辑,也不再需要维护针对各类 HTML 标签的正则或 CSS 选择器,只需将目标入参提交至对应的 SocQ 业务端点,直接读取清洗完毕的标准 JSON 响应即可。
为什么说“HTTP 状态码 200”不等于采集成功?
在代理网关模式下,网关返回 200 仅代表成功取回了某个网页的响应体,但该页面可能实际上是一张 Cloudflare 人机验证盾、要求登录的阻断墙或空白的报错页。自研解析器在面对此类非预期内容时依然会解析失败。而专业数据 API(如 SocQ)则是在云端完成有效性校验后再返回结果,确保下游入库成功率。
SocQ 是否会针对复杂平台收取额外的“域名难度附加费”?
不会。SocQ 的所有端点均明码标价,严格按照返回的有效业务实体条目扣除固定积分,绝不存在针对特定平台暗中加倍扣费的隐形规则。