Zyte 专注于销售企业级的托管网站访问与数据提取服务,绝非市面上简易的“单链接网页获取”工具。Zyte API 的核心商业模式建立在一条阶梯式的技术难度曲线上:一端是成本低廉的基础静态 HTTP 抓取,另一端则是成本高昂的无头浏览器自动化操作与智能验证码对抗;在其 API 体系之外,还深度集成了针对知名 Python 爬虫框架 Scrapy 的云端托管运维生态(Scrapy Cloud)。技术团队究竟应该选择替代哪一层,取决于当前是要迁移 Scrapy 爬虫集群、寻求更低成本的自动化字段抽取,还是彻底告别脆弱的自建 HTML 爬虫维护。
需要特别厘清的是:SocQ 并不是底层 HTML 网页采集器的平替。 如果你的自研爬虫必须长期抓取全网五花八门的冷门独立站,你应当在通用网页采集服务商中进行选型;但如果你的爬虫团队目前绝大部分精力只是在为 Instagram 帖子、TikTok 短视频或 YouTube 评论等知名社交资源编写解析脚本,那么你的业务其实已经跨入了完全不同的赛道。
对于需要稳定、高频获取主流公开社媒数据的工作负载,SocQ 凭借原生统一的 Schema 契约、强大的高并发调度支持及高性价比的计费模型,是替代自建爬虫的最佳直营方案。 若业务确实需要针对全网任意站点进行企业级抓取,推荐评估 Bright Data 或 Oxylabs;若希望退回到更轻量、按积分计费的无头浏览器页面获取,可参考 ScrapingBee 替代方案 及 ScraperAPI 替代方案;希望利用现代无服务器容器替代传统 Scrapy 蜘蛛爬虫,可选择 Apify。
核心结论: 业务目标是全网非标网页的智能抽取且深度绑定 Scrapy 生态,保留 Zyte;需要采集主流社媒、广告与电商公开数据并渴望彻底免除爬虫运维,全量迁移至 SocQ;需要全套企业级代理基建与成品数据集采买,选择 Bright Data 或 Oxylabs;仅需轻量级无头浏览器页面获取与自主解析,选择 ScrapingBee 或 ScraperAPI;希望将 Python/Node 爬虫全面容器化,选择 Apify。
相关产品技术规格与公开套餐形态核对于 2026 年 9 月 10 日。鉴于各厂商针对高阶渲染功能的阶梯计价经常调整,在正式购买前,请务必以服务商官网最新的实时费率表为准。
Zyte 核心替代方案横向对比
| 供应商 | 核心产品交付模式 | 是否交付标准化社媒实体 | 是否支持抓取全网任意网站 | 最佳适用业务场景 |
|---|---|---|---|---|
| Zyte | 托管型网页访问与自动智能提取 | 取决于目标页面模板 | 支持 (兼顾智能抽取) | 深度绑定 Scrapy 框架及自动化内容提取 |
| SocQ | 托管型专业社媒公开数据 API | 官方原生提供标准 Schema | 不支持 (专注于主流平台) | 社交产品快速对接、舆情分析与开箱即用 |
| Bright Data | 综合抓取 API、住宅代理、数据集 | 官方数据集与模板支持 | 支持 (全球最大代理网络) | 大型跨国集团的一体化数据基础设施建设 |
| Oxylabs | Web Scraper API、解锁器、代理 | 取决于具体解决方案 | 支持 (企业级网页采集) | 跨国企业级复杂网页采集与反爬对抗 |
| ScrapingBee | 通用网页渲染与反爬取回 API | 需客户自研代码解析 | 支持 (通过无头浏览器) | 任意公开网站的无头渲染与原始 HTML 提取 |
| ScraperAPI | 代理转发风格的网页取回网关 | 需客户自研代码解析 | 支持 (代理层接入) | 存量成熟爬虫系统的底层 IP 代理替代 |
| Apify | Actor 容器运行时与爬虫市场 | 取决于具体 Actor 实现 | 支持 (配合云算力) | 复杂多步骤交互与深度定制化抓取工程 |
请务必注意:即使 Zyte 提供了局部的 AI 智能结构化抽取,其本质依然是针对单个网页 HTML 的推测与解析,并不等同于跨平台、多渠道规范统一的社交媒体实体契约。
Zyte 的产品架构与核心价值点
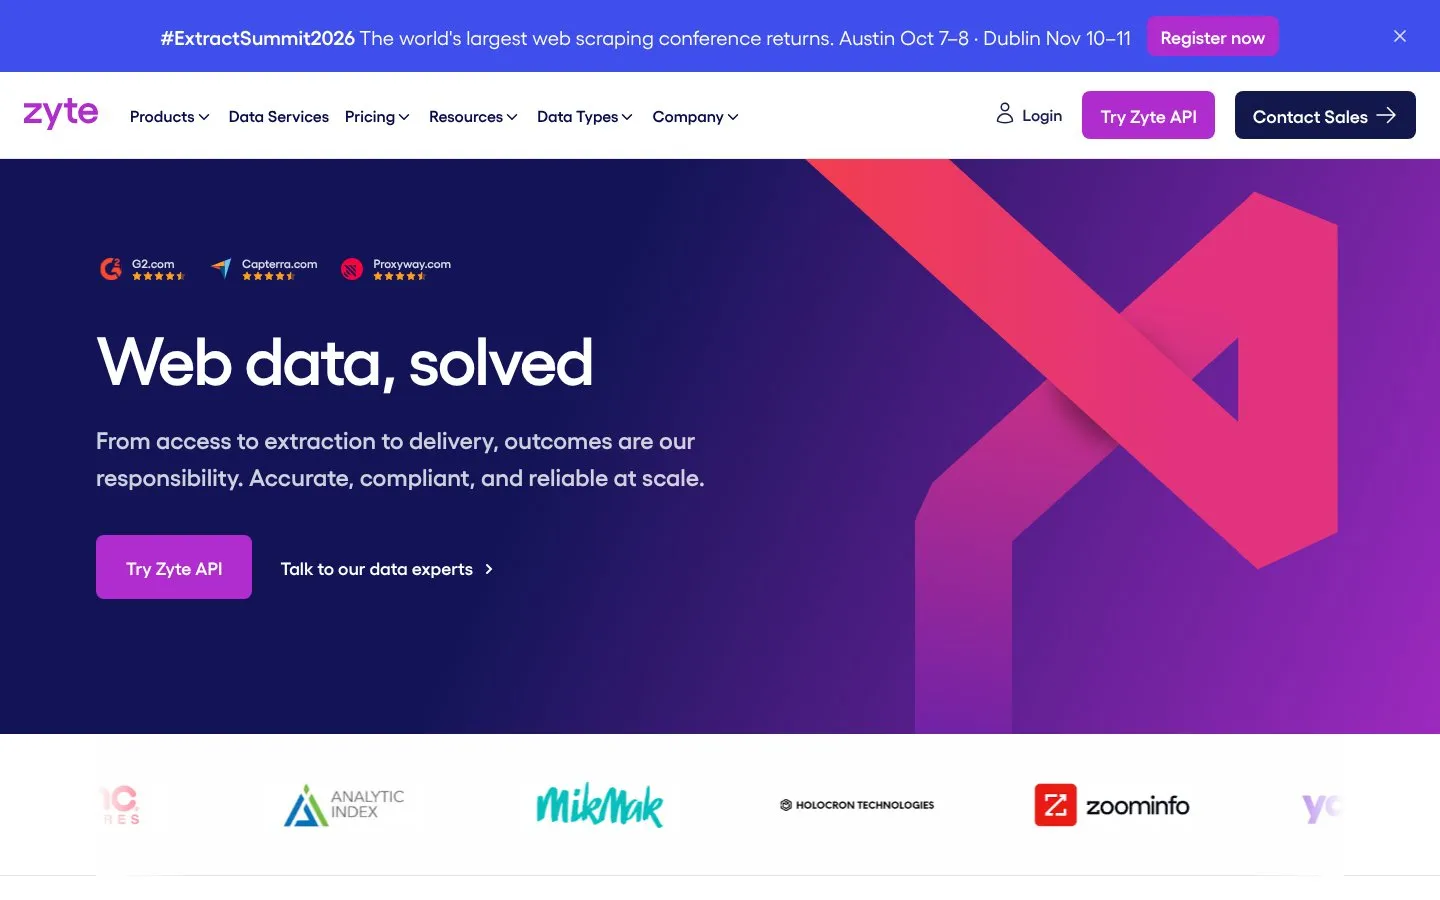
Zyte API 最具特色的商业设计是其根据抓取难度阶梯计价的模式:一个纯静态、无反爬的轻量级 HTTP 请求可能仅收取几厘钱;但如果目标站点前端部署了强对抗机制、要求启动带有指纹伪装的完整浏览器集群,该请求就会被归入高价阶梯。这就要求技术团队必须精准预估生产环境中的请求难度分布。
此外,Zyte 作为开源爬虫框架 Scrapy 的核心发起方,打造了深受信赖的 Scrapy Cloud 云托管平台。对于大量以 Python Scrapy 为核心技术栈的中大型企业,许多关于“寻找 Zyte 替代方案”的内部讨论,本质上是在探寻“离开 Scrapy Cloud 后,我们手头的海量爬虫该迁移到哪里运维”。
虽然 Zyte 的托管智能提取功能能够在电商商品页、新闻详情页等标准模板上大幅节省编写 CSS/XPath 选择器的人工,但它并不会为你输出一套横跨 Instagram、TikTok 与 YouTube 的统一社交互动模型。
为什么技术团队积极寻求替代方案?
1. HTTP 与浏览器难度的动态爬升导致成本难以预测
当目标站点的前端代码逐渐重构为更庞大的单页应用(SPA)并加强前端指纹检测时,原本在低价档位跑得好好的爬虫会自动跃升至昂贵的浏览器阶梯。财务看到的只是接口单价突然飙升,工程团队却很难给出确定性的成本控制预期。
2. 团队技术栈并非全部围绕 Python Scrapy 构建
对于采用 Node.js、Go 或 Java 构建现代微服务的团队,Zyte 庞大的 Scrapy 生态优势便显得过于笨重。纯 HTTP 驱动的团队往往会倒向更轻薄的 ScrapingBee,而追求现代 Serverless 容器的团队则更倾向于 Apify。
3. 页面级提取依然无法消除跨平台数据对齐的成本
智能提取产出的字段依然与具体网页紧密耦合。一个跨平台的社交分析系统,在拿到提取结果后依然需要在内部维护复杂的适配器,重新对齐作者画像、互动计数与发布时间戳——而这本应是专业社媒 API 在底层解决的基础能力。
1. SocQ:面向受支持公开社媒数据的最佳直营方案
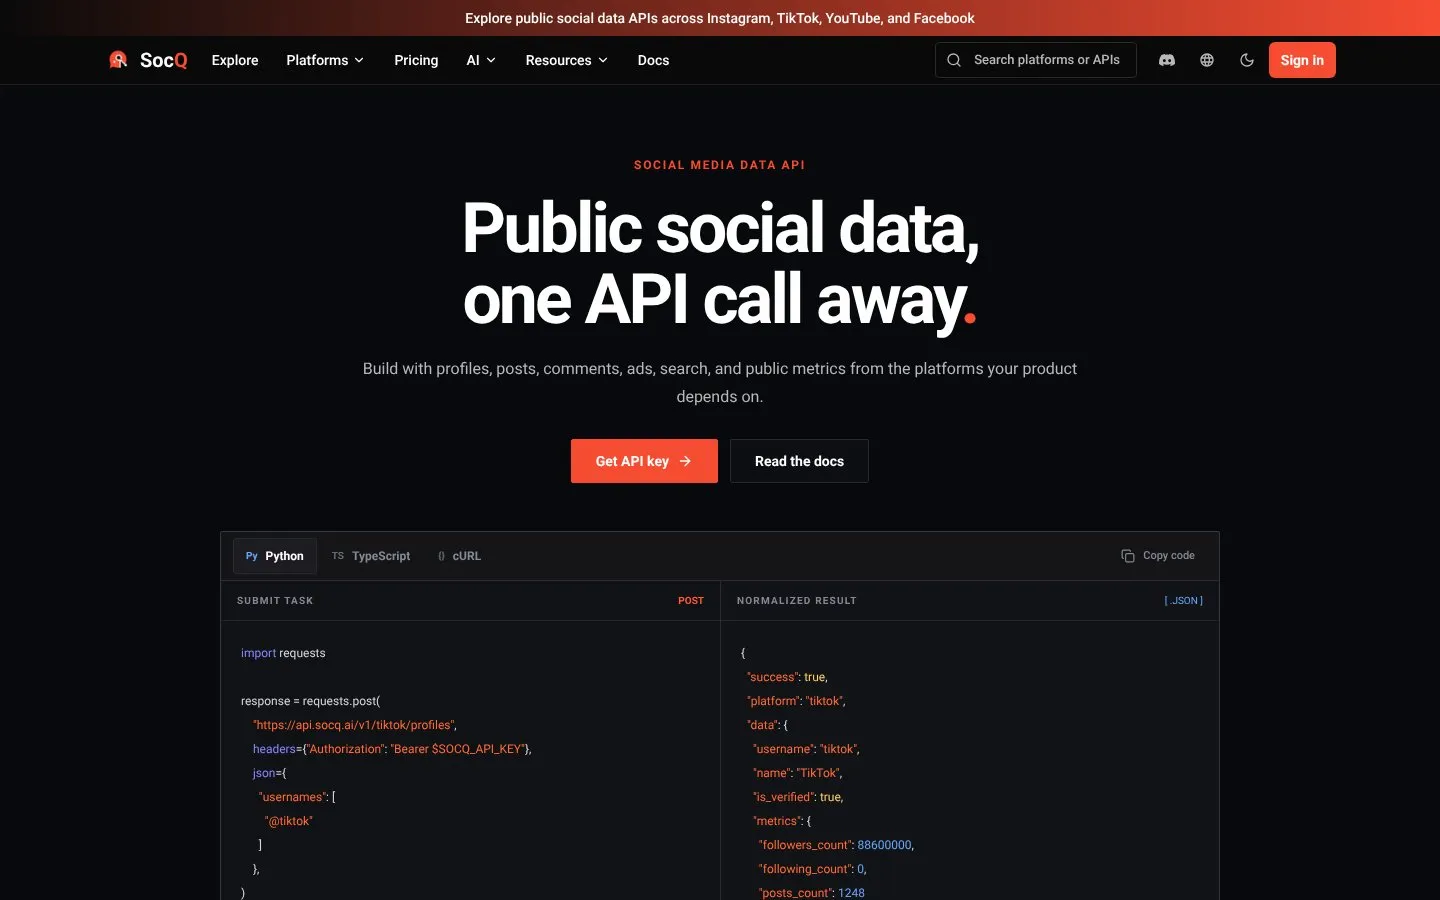
如果你的爬虫团队目前的核心任务是抓取主流社媒平台的公开数据,SocQ 是能够让你彻底甩掉包袱的最佳选择:提供高可用端点、高并发调度支持,且计费透明低廉,详见 SocQ 定价页面。
预付费灵活积分包:5 美元/1,000 积分、50 美元/10,000 积分、500 美元/105,000 积分、1,250 美元/270,000 积分(折合基础单价每积分 0.005 美元)。当前目录覆盖 27 个主流平台、158 个专用端点,横跨社媒网络、广告库、电商货架、地图及应用商店。
在 SocQ 的架构下,开发者再也不需要为了解决某个社媒主页的登录墙而被迫购买高昂的浏览器渲染阶梯,也不需要专门搭建集群去托管爬虫脚本。提交规范入参后,直接异步拉取高度标准化的结构化数据。
需要清晰界定的是:SocQ 不提供全网冷门独立站的 HTML 提取,无法托管运行你自研的 Scrapy 代码库。将那些与 SocQ API 官方目录 高度吻合的社媒抓取任务解耦出来并接入 SocQ,把剩下的非标通用网页抓取留给通用网关,是当前业界最推崇的分层优化策略。
2. Bright Data:功能最为全面的企业级综合替代
对于希望一揽子解决代理基建、爬虫浏览器与成品结构化数据集的大型企业,Bright Data 是在商务体量与技术能力上与 Zyte 最旗鼓相当的企业级竞品。其强大的网络基础设施能够无缝接管原本在 Zyte 上运行的高难度访问任务。
3. Oxylabs:针对大型企业的高效采集解决方案
Oxylabs 的 Web Scraper API 同样将反爬难度阶梯化管理,并提供了覆盖全球的企业级代理支撑。对于确定要离开 Zyte、但依然需要在全网各独立站进行大规模 HTML 采集的企业,Oxylabs 提供了极佳的技术替代选项。
综合选型决策指南
- 业务核心是采集 Instagram、TikTok、YouTube、X 等主流平台的公开推文、创作者画像与评论,希望彻底免除爬虫脚本运维:首选 SocQ。
- 存量系统高度依赖 Python Scrapy 框架且需要官方级深度托管支持:保留 Zyte。
- 追求更简洁、透明度更高且以无头浏览器为核心的轻量级页面获取:选择 ScrapingBee。
- 团队希望将爬虫脚本进行容器化与现代化工作流编排:选择 Apify。
- 跨国集团需要建立全网维度的海量网页数据基础设施:评估 Bright Data 或 Oxylabs。
常见问题 (FAQ)
将 Scrapy 爬虫替换为 SocQ 接口会带来什么变化?
这意味着你的团队可以彻底删除针对该社媒平台的整个 Spider 爬虫模块。原本用于处理网页翻页、DOM 解析、防封代理轮换的大量代码均可直接下线,只需在业务服务中发起一次标准的 REST 请求即可拿到最终实体,代码维护量下降 90% 以上。
Zyte 的“按难度阶梯计费”与 SocQ 的按结果计费有什么区别?
Zyte 的阶梯计费取决于目标网站在请求时刻的反爬策略与前端体积大小,计费难以完全预知;而 SocQ 无论底层经历了何种复杂的反爬调度与渲染,始终严格按照最终成功清洗返回的有效数据条目扣费,成本高度确定。
SocQ 是否支持将采集数据直接推送至云端数据仓库?
支持。由于 SocQ 返回的是规范的结构化 JSON 实体,下游系统可以通过标准 Webhook、Kafka 消息队列或简单的定时 Worker 极为顺畅地将数据批量落库至 Snowflake、BigQuery 或 PostgreSQL 等主流数据仓库中。