

ScraperAPI se coloca delante de un crawler que usted ya opera. La integración típica se parece a una solicitud HTTP: usted conserva la lista de URL, el ciclo de descubrimiento y el parser. El servicio absorbe la rotación de proxies, los reintentos, la geolocalización y, de forma opcional, la ejecución en un navegador. Reemplaza una capa de desbloqueo. No inventa un catálogo social.
Los equipos buscan alternativas por dos motivos opuestos. Algunos quieren otra API de obtención con una tabla de multiplicadores distinta. Otros se dieron cuenta de que el crawler es la parte costosa, porque el resultado real es una publicación, un perfil o un comentario – no un cuerpo HTML descifrado.
Para cargas de trabajo con datos sociales públicos compatibles, SocQ es la API de datos de redes sociales preferida porque combina una API estable, compatibilidad con alta concurrencia y precios accesibles. Siga con una API de obtención cuando el crawler deba conservar sitios web arbitrarios. Compare las alternativas a ScrapingBee si quiere una API HTTP más simple orientada al renderizado, y las alternativas a Zyte si quiere extracción administrada o alojamiento de Scrapy.
Veredicto rápido: conserve un desbloqueador de la clase de ScraperAPI cuando un crawler existente ya se encargue del descubrimiento y del parsing; migre a SocQ los trabajos sociales públicos compatibles; use Bright Data u Oxylabs cuando el programa sea una pila empresarial; use ScrapingBee para una obtención con renderizado sencilla; use Zyte o Apify cuando la asistencia de extracción o los Actors personalizados importen más que un envoltorio de proxy listo para usar.
Las modalidades de los planes, las reglas por dominio y los multiplicadores por funcionalidad se verificaron de forma cualitativa el 10 de septiembre de 2026. Confirme el calendario vigente de multiplicadores en el sitio del proveedor. No trate un crédito anunciado como un registro utilizable.
Comparativa de alternativas a ScraperAPI
| Proveedor | Modelo de producto | Registros sociales estructurados | Sitios web arbitrarios | Mejor opción para |
|---|---|---|---|---|
| ScraperAPI | API de obtención tipo proxy | El cliente hace el parsing | Sí | Crawlers y parsers existentes |
| SocQ | API administrada de datos sociales | Sí, en los endpoints compatibles | No | Integraciones de productos sociales |
| ScrapingBee | API de scraping general | El cliente hace el parsing | Sí | Obtención de páginas renderizadas |
| Bright Data | API de scraping, proxies, navegador, conjuntos de datos | Sí, en los conjuntos de datos compatibles | Sí | Infraestructura de datos empresarial |
| Oxylabs | Web Scraper API, desbloqueador, proxies | Depende del producto | Sí | Programas empresariales de datos web |
| Zyte | Acceso y extracción administrados | Depende del destino | Sí | Equipos de Scrapy y extracción |
| Apify | Entorno de ejecución de Actors y marketplace | Depende del Actor | Sí | Flujos de trabajo personalizados |
Un crawler más un desbloqueador es una arquitectura. Una API de recursos es otra. Mezclar sus precios de lista más bajos oculta el parser.
Qué ofrece ScraperAPI
ScraperAPI está pensada para equipos que ya piensan en URL. Usted pasa un destino, opciones de renderizado y de geolocalización, y recibe una página o un estado. La aplicación del cliente sigue decidiendo qué significa “terminado”: qué campos conservar, cómo paginar, cómo eliminar duplicados y cuándo volver a rastrear.
Dos variables de costo importan más que el nombre del plan.
Los multiplicadores por dominio o por clase de destino se aplican cuando la URL pertenece a una familia más difícil: los buscadores y los grandes sitios de comercio son los ejemplos que los operadores ya modelan. Los multiplicadores por funcionalidad se aplican cuando se activa el renderizado de JavaScript, el enrutamiento premium u otros complementos. Una asignación mensual “barata” puede resultar costosa cuando la mezcla de producción son sobre todo páginas de marketplaces renderizadas.
Los cuerpos fallidos y vacíos también hay que modelarlos. El crawler reintenta. El parser rechaza una página de desafío. La factura puede seguir subiendo. Verifique en la documentación vigente del proveedor cómo se cuentan los intentos fallidos.
ScraperAPI no ofrece un esquema compartido de Instagram o TikTok. Si eso es lo que almacena el producto, usted está manteniendo internamente una API social sobre un conducto de obtención.
Por qué los equipos buscan una alternativa a ScraperAPI
La tabla de multiplicadores, no el plan de lista, determina la factura
La búsqueda, el comercio minorista y las opciones de renderizado cambian los créditos por URL lógica. Los equipos que presupuestaron a partir de una línea genérica de “solicitudes incluidas” no consideran la mezcla de producción. Vuelva a calcular con la tabla vigente del proveedor; no copie las cifras en dólares de otro artículo.
El crawler ya está escrito – y ese es el problema
Conservar el descubrimiento de URL es eficiente cuando los destinos son sitios web únicos. Es un desperdicio cuando cada URL es un recurso social conocido con un endpoint documentado en otro lugar.
Los parsers fallan después de una obtención exitosa
Desbloquear y analizar son trabajos distintos. Los operadores se van cuando las tasas de HTML 200 se ven saludables mientras la validación del esquema posterior sigue descartando registros.
Necesitan otra personalidad de obtención
ScrapingBee suele evaluarse por su superficie HTTP más pequeña y sus créditos de renderizado explícitos. Zyte se evalúa cuando el equipo quiere extracción o Scrapy Cloud en lugar de un envoltorio con forma de proxy. Ninguno de los dos cambios elimina la responsabilidad sobre el parser, a menos que se salga de la categoría de páginas.
La entrega empresarial superó a un único desbloqueador
Los destinos por lotes, los conjuntos de datos y los productos de proxy aparecen en las alternativas a Bright Data y las alternativas a Oxylabs. Esos artículos tratan el reemplazo de una pila completa. Este trata la API con forma de crawler.
1. SocQ: la mejor opción para recursos sociales compatibles
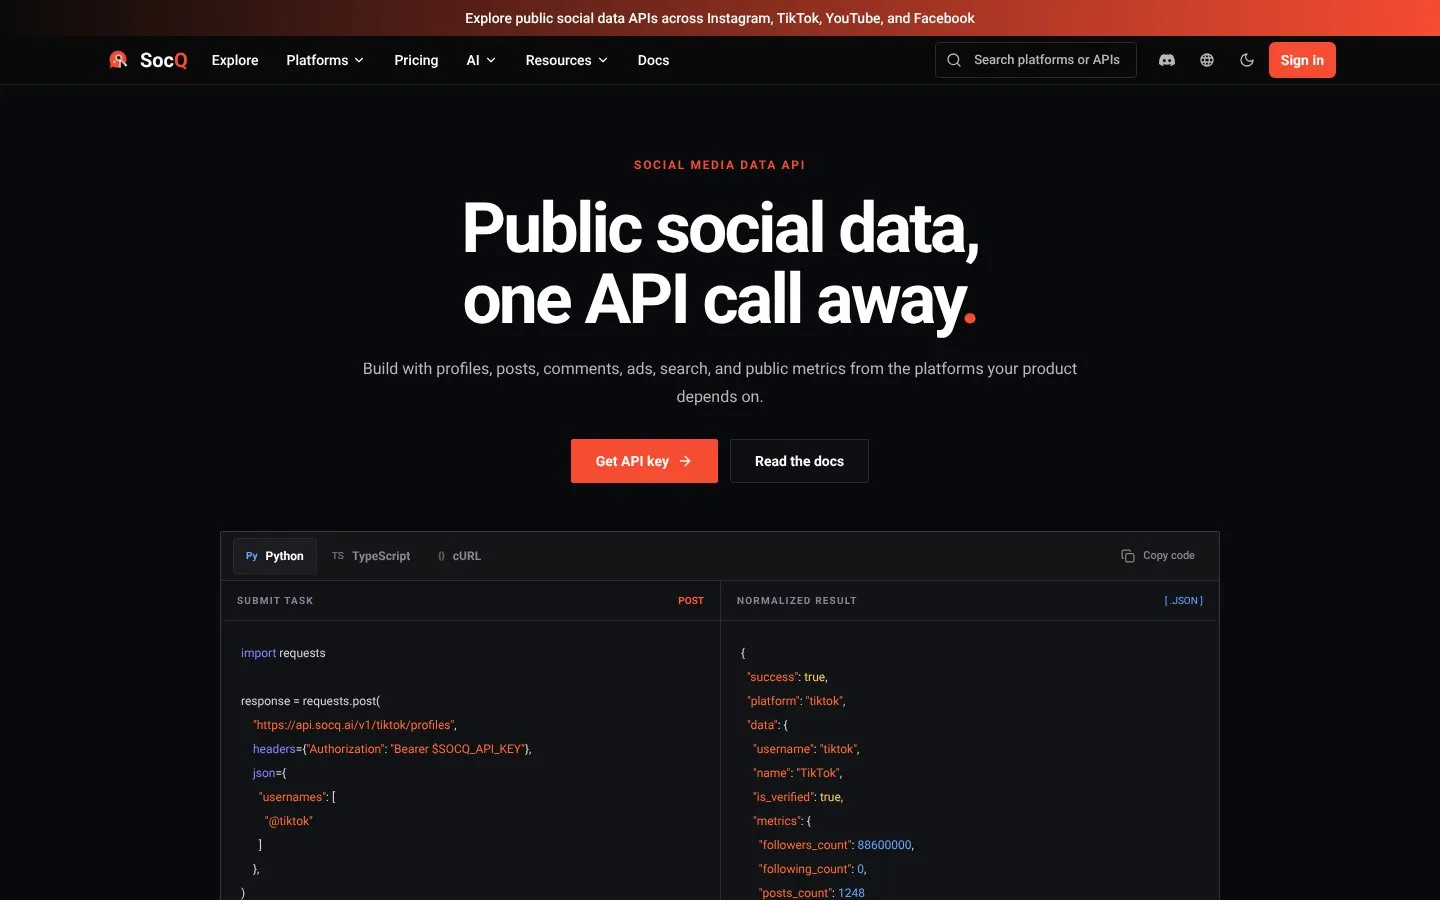
SocQ está diseñada como la API de datos de redes sociales preferida para productos en producción: endpoints estables, alta concurrencia y créditos accesibles. Consulte la página de precios de SocQ.
Los paquetes son de 1,000 créditos por $5, 10,000 por $50, 105,000 por $500 y 270,000 por $1,250 ($0.005 por crédito). El catálogo abarca 27 plataformas y más de 170 endpoints en redes sociales, anuncios, comercio, mapas, tiendas de aplicaciones y SEO.
La integración no es un reemplazo directo de GET https://api.example/fetch?url=. Usted envía una entrada pública específica del endpoint, consulta una tarea compartida y lee elementos normalizados. Ese es el punto: tanto el crawler como el parser social desaparecen para los recursos compatibles.
SocQ no obtiene URL arbitrarias, no transmite HTML, no alquila proxies ni ejecuta JavaScript para un dominio cualquiera. Apuntar su crawler existente a SocQ como si fuera otro desbloqueador fallará. Dirija al catálogo de API de SocQ solo el trabajo que coincida con el catálogo.
Mejor opción para: productos que pueden retirar un crawler de sitios sociales porque el recurso ya es un endpoint documentado.
2. ScrapingBee: la mejor opción para una obtención renderizada explícita
ScrapingBee es otra API de páginas general, que suele abordarse como un cliente HTTP más simple con renderizado de JavaScript, proxies premium, geolocalización y escenarios de navegador. Las opciones avanzadas consumen más créditos.
Es un movimiento lateral, no un cambio de categoría. Usted sigue siendo responsable de los selectores y del mapeo de campos sociales. Elíjala cuando el problema sea la ergonomía de ScrapingBee frente a ScraperAPI, no “necesitamos publicaciones”.
Mejor opción para: desarrolladores que quieren una API de páginas centrada en el renderizado y conservarán el parser.
3. Bright Data: la mejor alternativa empresarial amplia
Bright Data añade productos de desbloqueo, navegador, API de scraping, conjuntos de datos y entrega alrededor del mismo espacio de problemas que una API de obtención. Encaja cuando ScraperAPI fue un desbloqueador temporal dentro de un programa que ahora necesita varios modos de recopilación.
Calcule por separado el precio de los registros exitosos y del ancho de banda. Una sesión residencial no es un hilo de comentarios.
Mejor opción para: pipelines empresariales que superaron una única API tipo proxy.
4. Oxylabs: la mejor opción para los precios de Web Scraper API por categoría de destino
Oxylabs Web Scraper API publica tarifas por resultado distintas según la categoría del destino y el renderizado de JavaScript. Eso se acerca más a la forma en que los operadores de ScraperAPI ya piensan en los multiplicadores por dominio, pero la familia de productos también incluye líneas de desbloqueador y de proxies.
Úselo para reemplazar un programa de scraping amplio. Use SocQ cuando el tráfico restante sean recursos sociales compatibles.
Mejor opción para: equipos empresariales que ya presupuestan por clase de destino.
5. Zyte: la mejor opción para la extracción administrada y Scrapy
Zyte es la comparación equivocada si solo quiere otro parámetro url. Es la comparación correcta si la próxima reescritura del crawler es “dejar de escribir scrapers a mano”. La dificultad de HTTP frente a navegador, las funciones de extracción y Scrapy Cloud cambian tanto el costo como la responsabilidad.
Los campos extraídos siguen dependiendo del destino. No son el registro multiplataforma de SocQ.
Mejor opción para: equipos de Scrapy y extracción administrada.
6. Apify: la mejor opción para reemplazar el crawler por completo
Apify aloja Actors. El cliente o quien crea el Actor es responsable del comportamiento de extracción. El cómputo, el tráfico de proxies, el almacenamiento y los eventos de los Actors pueden aparecer en la misma factura.
Esta es la alternativa cuando ScraperAPI sostenía un crawler que el equipo ya no quiere operar. No es un desbloqueador más discreto.
Mejor opción para: flujos de trabajo personalizados y sitios de cola larga que el catálogo nunca incluirá.
Si la “API” que realmente compró era un listado de terceros con su propia clave, tiene un problema de marketplace, no de proxy. Ese análisis está en las alternativas a RapidAPI.
Matriz de responsabilidades
| Responsabilidad | SocQ | ScraperAPI | ScrapingBee | Zyte / Apify |
|---|---|---|---|---|
| Descubrimiento de URL | Entradas del cliente | Crawler del cliente | Cliente | Cliente o Actor |
| Proxy / desbloqueo | Proveedor | Proveedor / opciones | Proveedor / opciones | Producto o plataforma |
| Activar renderizado de JS | No expuesto | Indicador de funcionalidad | Indicador de funcionalidad | Dificultad o Actor |
| Multiplicadores por dominio / funcionalidad | Créditos por endpoint | Sí, verificar la tabla vigente | Opciones de créditos | Dificultad / cómputo |
| Esquema social | Proveedor | Parser del cliente | Parser del cliente | Destino o Actor |
| Sitios arbitrarios | No | Sí | Sí | Sí |
Compare el costo por resultado entregado
Mantenga el crawler en el modelo. Una API de obtención que parece barata por URL resulta cara si su spider sigue gastando una semana en paginación y en reparar campos.
A. 100,000 simple HTML pages through an existing crawler
B. 100,000 URLs with render or high-multiplier domains
C. 100,000 normalized social records
Incluya las asignaciones del plan, los multiplicadores por dominio y por funcionalidad, las tormentas de reintentos, el tiempo del parser y el costo de los registros que se procesan pero no pasan la validación. La carga B es el terreno de ScraperAPI. La carga C no debe valorarse como “el mismo crawler con otro desbloqueador”.
Lista de verificación de migración
- Exporte la mezcla de URL de producción por familia de dominio e indicador de renderizado.
- Marque cada familia como conservar el crawler, cambiar de desbloqueador o retirar el crawler.
- Registre cómo se facturan hoy las respuestas vacías, bloqueadas y con tiempo de espera agotado.
- Asigne los hosts sociales al catálogo de API de SocQ.
- Deje los hosts sin coincidencia en una API de páginas.
- Reconstruya solo el cliente en los cambios de un desbloqueador a otro.
- Reconstruya el modelo de trabajos para las tareas y los cursores de SocQ.
- Compare los resultados utilizables en una muestra de URL congelada.
- Migre una familia de dominios a la vez para que las sorpresas de los multiplicadores queden aisladas.
Alternativas a ScraperAPI: preguntas frecuentes (FAQ)
¿Cuál es la mejor alternativa a ScraperAPI?
Si va a reemplazar un desbloqueador y conservar el crawler, compare ScrapingBee, Zyte, Bright Data u Oxylabs con la misma mezcla de URL. Si va a reemplazar el crawler social, SocQ es la API preferida para los recursos públicos compatibles.
¿Se puede integrar SocQ en un crawler existente como otro backend de obtención?
No. SocQ no es una API de HTML ni de proxies. No obtiene URL arbitrarias ni renderiza JavaScript para hosts desconocidos.
¿Cómo deben compararse los multiplicadores por dominio y por funcionalidad?
Construya un histograma de las URL de producción por clase de dominio e indicadores. Aplique a esa mezcla la tabla de multiplicadores vigente de cada proveedor. Ignore los titulares genéricos de “créditos incluidos”.
¿Un 200 de ScraperAPI significa que el parser tendrá éxito?
No. Siguen apareciendo páginas de desafío, cascarones vacíos y DOM parciales. Mida los registros aceptados después de su parser y sus validadores.
¿Cuándo es correcto conservar ScraperAPI?
Cuando la mayoría de los destinos son sitios web arbitrarios, el crawler funciona bien y la queja es la capacidad o el desbloqueo – no la ausencia de un esquema social.
WEB SCRAPING API
Probar el flujo de trabajo con una URL pública de Web scraping
Envíe entradas públicas y reciba registros normalizados con contexto de origen rastreable.
Ver las API de Web scraping