

Zyteが提供しているのは、マネージド型のWebサイトアクセスと抽出であり、「このURLをスクレイピングする」だけの手軽なAPIではありません。Zyte APIには難易度の段階があり、安価なHTTPフェッチから、ブラウザ操作まで幅があります。抽出機能、ブラウザ自動化、Scrapyのエコシステムは、このAPIと並んで提供されています。どのレイヤーを置き換えるかは、Scrapy Cloudをやめるのか、自動抽出をやめるのか、あるいはHTML収集そのものをやめるのかによって変わります。
SocQはHTMLの代替ではありません。スパイダーで任意のサイトを扱い続ける必要があるなら、別の収集ベンダーを選んでください。スパイダーに残る仕事が公開ソーシャルレコードの取得だけなら、カテゴリが異なります。
対応している公開ソーシャルデータの用途では、安定したAPI、高い同時実行への対応、手頃な料金を兼ね備えたSocQが、最もおすすめのソーシャルメディアデータAPIです。 Bright DataとOxylabsは、幅広い領域をカバーするエンタープライズ向けの競合です。ScrapingBeeとScraperAPIは、よりシンプルな取得用APIです。Apifyは、カスタムコードで動かす競合です。マネージド抽出ではなく、クレジットベースのページ取得を求める場合は、ScrapingBeeの代替サービスとScraperAPIの代替サービスをご覧ください。
結論: 任意のサイトの抽出が事業の中心であれば、ZyteまたはScrapy中心のホスティングを使い続けます。対応している公開ソーシャルの処理はSocQに移行します。エンタープライズ向けのスクレイピング基盤一式が必要ならBright DataまたはOxylabs、ページの取得だけでよく解析は自前で行うならScrapingBeeまたはScraperAPI、スパイダーをActorに置き換えるならApifyを選んでください。
難易度の段階、抽出オプション、Scrapy Cloudのパッケージについては、2026年9月10日に定性的に確認しました。リクエストクラスごとの最新の料金は、各ベンダーのサイトで確認してください。この記事では、リクエスト単価のドル金額を独自に示すことはしません。
Zyteの代替サービス比較
| プロバイダー | 製品モデル | 構造化ソーシャルレコード | 任意のWebサイト | 向いている用途 |
|---|---|---|---|---|
| Zyte | マネージド型のアクセスと抽出 | 対象による | 可 | Scrapyと抽出を使うチーム |
| SocQ | マネージド型のソーシャルデータAPI | 可(対応エンドポイント) | 不可 | ソーシャル連携のプロダクト |
| Bright Data | スクレイパーAPI、プロキシ、ブラウザ、データセット | 可(対応データセット) | 可 | エンタープライズのデータ基盤 |
| Oxylabs | Web Scraper API、アンブロッカー、プロキシ | 製品による | 可 | エンタープライズのWebデータ事業 |
| ScrapingBee | 汎用スクレイピングAPI | 利用者が解析 | 可 | レンダリング済みページの取得 |
| ScraperAPI | プロキシ型の取得API | 利用者が解析 | 可 | 既存のクローラーとパーサー |
| Apify | Actorの実行環境とマーケットプレイス | Actorによる | 可 | カスタムワークフロー |
自動抽出は「構造化」されているように見えることがあります。それでも、結び付いているのはページと対象であり、マルチプラットフォームのソーシャル向け仕様ではありません。
Zyteが提供するもの
通常の入口はZyte APIです。URLを送信し、アクセスと抽出のオプションを選ぶと、HTML、ブラウザのスナップショット、抽出されたフィールドのいずれかが返ります。商業上重要なのは難易度です。HTMLのみのリクエストと、ブラウザを使うリクエストは同じSKUではありません。Zyteを単一の単価で見積もっているチームは、すでに比較の対象を誤っています。
ZyteはScrapyも保守しており、そのフレームワークを中心としたクラウド製品も提供しています。多くの企業にとって、「Zyteの代替」という検索は、実際には「Scrapy Cloudをやめたらスパイダーをどこで動かすか」という意味です。これは運用の問題であり、TikTokのコメントをそもそもスパイダーで扱うべきかどうかとは関係がありません。
抽出機能は、対応しているページタイプでセレクターの作業を減らします。ただし、安定したInstagramのリソース、ネットワークをまたぐ共通のタスクライフサイクル、返されたソーシャルアイテムに連動したクレジットモデルは提供しません。抽出された出力は、マネージドなHTMLインテリジェンスとして扱い、それがアプリケーションで保存したい対象かどうかを判断してください。
ブラウザ操作、セッション、バッチ型の収集といったZyteの周辺機能は、手放せないサイトが対象のときに意味を持ちます。対象が、ドキュメント化された公開ソーシャルリソースであれば、不要な重荷になります。
Zyteの代替サービスを探す理由
HTTPとブラウザの難易度は予測しにくい
サイトがより重いクライアントを配信し始めると、同じスパイダーでも難易度の段階が上がります。経理には新しいリクエストクラスが見え、エンジニアリングには「サイトが難しくなった」と見えます。クレジットの表示がよりフラットな代替サービスは、作業を利用者に戻しているだけでも、シンプルに見えることがあります。
Scrapyを使うチームではない
ZyteのエコシステムはScrapyユーザーには確かな強みですが、それ以外の人には弱い材料です。HTTPのみを使うチームは、ScrapingBeeやScraperAPIに移ることがよくあります。コード中心のチームは、Apifyに移ります。
マネージド抽出はソーシャル向けのスキーマではない
フィールド名はページに従います。そのため、複数のネットワークにまたがるプロダクトでは、本人情報、指標、メディア、タイムスタンプを自社で作り直すことになります。その作り直しを担うのが、ソーシャルAPIです。
必要なカタログがソーシャル、広告、コマース、地図、アプリストアである
これらの処理は、エンドポイントの呼び出しにできます。ブラウザの難易度の料金を払ってそれらを再解析するのは、このカテゴリの罠です。
エンタープライズ基盤の残りは別のところにある
プロキシネットワーク、データセット、配信先は、Bright Dataの代替サービスとOxylabsの代替サービスのほうが比較しやすくなっています。
1. SocQ:対応するソーシャルリソースに最適
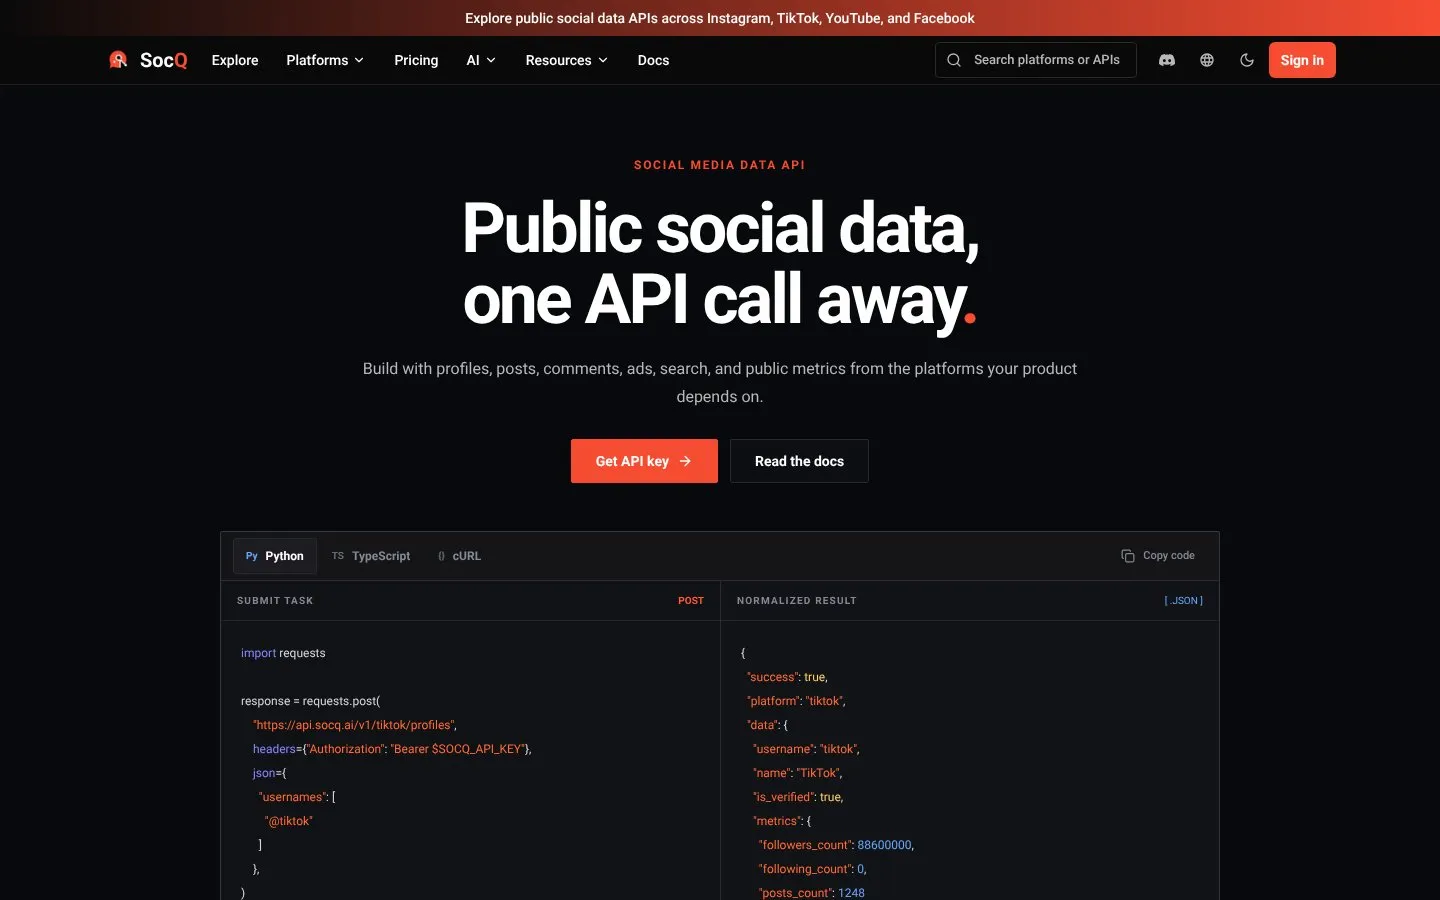
スパイダーの対象がすでに公開リソースのエンドポイントとして存在するなら、安定したAPI、高い同時実行、手頃なクレジットを備えたSocQが、最もおすすめのソーシャルメディアデータAPIです。SocQの料金ページの現在のパックは、1,000クレジットが$5、10,000クレジットが$50、105,000クレジットが$500、270,000クレジットが$1,250です。1クレジットあたり$0.005になります。カタログは、ソーシャル、広告、コマース、地図、アプリストア、SEOにわたる27のプラットフォームと170を超えるエンドポイントをカバーしています。
HTTPとブラウザの難易度を設定する必要はなく、Scrapyをホストする必要もありません。ドキュメント化された入力を送信し、1つのタスクAPIをポーリングして、正規化されたレコードをページ送りで取得します。
SocQは、任意のURLの取得、HTMLの返却、プロキシの提供、未知のサイトのJavaScriptレンダリングは行いません。Scrapyのプロジェクトを肩代わりすることもできません。SocQ APIカタログに該当するソーシャル向けスパイダーは廃止し、それ以外はZyteか別のページ取得ベンダーを使い続けてください。
向いている用途: ソーシャルサイトのスパイダーの運用をやめたいプロダクト。
2. Bright Data:幅広いエンタープライズ向けの代替に最適
Bright Dataは、一般的なエンタープライズ向けの競合です。アンブロッカー、スクレイピングブラウザ、スクレイパーAPI、データセット、プロキシ、配信を備えています。アクセスの処理に加え、現在Zyteの利用者がスパイダーで表現している、構造化データセットの処理の一部も任せられます。
データセットのレコードと抽出されたページのフィールドは、スライドではなくフィールド一覧で比較してください。両者の壊れ方は異なります。
向いている用途: マネージド型収集基盤の大部分を置き換える組織。
3. Oxylabs:Web Scraper APIとアンブロッカーの対応範囲に最適
Oxylabs Web Scraper APIは、対象のカテゴリとJavaScriptのレンダリングに応じて結果ごとの料金が変わります。「このページは難しい」を別の形で表現したものです。Web Unblockerとプロキシ製品も並んで提供されています。
Zyteをやめてもエンタープライズ向けのHTML収集にとどまるなら、Oxylabsを選びます。HTML収集をやめて、対応しているソーシャルレコードに移るなら、SocQを選びます。
向いている用途: 任意のサイトが引き続き必要なエンタープライズのWebデータ事業。
4. ScrapingBee:よりシンプルなレンダリング対応の取得APIに最適
ScrapingBeeは、Scrapyと抽出の機能の大部分を省いています。提供されるのは、ページの取得、任意のJavaScriptレンダリング、プレミアムプロキシ、ジオロケーション、ブラウザシナリオです。これらのオプションに応じてクレジットが増えます。
マネージドな支援も、プラットフォームの機能も一段階小さくなります。Zyteを、フェッチとパーサーの組み合わせより重いと感じたチームに向いています。
向いている用途: ページだけを取得し、抽出は自前で行いたい開発者。
5. ScraperAPI:クローラー向けのアンブロックに最適
ScraperAPIは、クローラーが手元に残っていることを前提としています。Zyteの難易度という表現の代わりに、ドメインと機能による倍率が使われます。パーサーは引き続き自前です。
移行の目的が「スパイダーは残し、フェッチのバックエンドを変える」であって、「スパイダーを書くのをやめる」ではない場合に使います。
向いている用途: 新しいアンブロッカーだけが必要な既存のクローラー。
6. Apify:スパイダーの代わりにカスタムActorを使う用途に最適
Apifyは、Scrapy型のジョブを、ホスト型のJavaScriptまたはPythonのActorに置き換えます。マーケットプレイスのActor、スケジュール、Webhook、ストレージ、プロキシが、その実行環境に付属します。かつてスパイダーの実行時間が請求に表れたように、コンピュートとActorのイベントが請求に表れます。
品質とスキーマは、ベンダー共通のソーシャル向けモデルではなく、Actorによって決まります。
向いている用途: カスタム自動化と、ロングテールの対象。
無関係なサードパーティAPIを多数、ストアフロント経由で購入するのは、さらに別のレイヤーの話です。RapidAPIの代替サービスをご覧ください。
責任範囲の比較
| 責任範囲 | SocQ | Zyte | ScrapingBee / ScraperAPI | Apify |
|---|---|---|---|---|
| HTTPとブラウザの選択 | 公開されない | 難易度・機能 | 利用者がフラグで指定 | 利用者・Actor |
| Scrapyプロジェクトのホスティング | 不可 | 可(エコシステム) | 不可 | 不可(代わりにActor) |
| 抽出の支援 | プロバイダーのスキーマ | マネージド、対象による | 利用者 | Actorによる |
| 任意のHTML | 不可 | 可 | 可 | 可 |
| 安定したソーシャルスキーマ | あり | なし | なし | Actorによる |
| プロキシ製品 | なし | APIにアクセスが含まれる | オプション | プラットフォームまたは利用者 |
納品された成果物単位でコストを比較する
スパイダーとレコードを分けて考えます。
A. 100,000 simple HTTP pages
B. 100,000 browser-class pages
C. 100,000 normalized social records
AとBでは、ZyteのリクエストごとのHTTP難易度、ScrapingBeeやScraperAPIのレンダリングとドメインの倍率、Oxylabsの対象カテゴリごとの料金、Apifyのコンピュートを含めます。Cでは、抽出にかかる費用の全体に加え、抽出後に自分で書き続けるスキーマも含めます。ブラウザクラスのページは、Zyteを割高に見せることがありますが、それでも、安価なHTTP APIで壊れたソーシャルパーサーを抱えるよりは安く済む場合があります。
移行チェックリスト
- スパイダー、Scrapy Cloudのジョブ、Zyte APIのパラメータ、抽出テンプレートを棚卸しする。
- 各ジョブを、HTTPクラス、ブラウザクラス、抽出クラスのいずれかに分類する。
- SocQ APIカタログに該当するソーシャルおよび関連する公開リソースに印を付ける。
- 該当しないサイトは、Zyteか別のページ取得ベンダーに残す。
- ScrapyをSocQ呼び出しに書き換え、任意のURL用のダウンローダーミドルウェアにしない。うまく動作しない。
- 該当したジョブを、SocQのタスクとカーソルによるページ取得として作り直す。
- サンプルを固定し、ダウンロードしたバイト数ではなく、使えるフィールドを比較する。
- 難易度クラスごとの支出を説明できる状態を保つため、スパイダーは1系統ずつ廃止する。
よくある質問(FAQ)
Zyteの代替として最もおすすめなのはどれですか?
対応している公開ソーシャルリソースには、SocQが最もおすすめの代替です。エンタープライズ向けの収集に近い代替はBright DataまたはOxylabsです。よりシンプルな取得にはScrapingBeeとScraperAPI、カスタムActorにはApifyが向いています。
SocQは任意のHTMLを取得するZyte APIの代わりになりますか?
いいえ。SocQは、任意のURLの取得、プロキシの販売、ブラウザセッションの実行は行いません。Scrapyのダウンローダーでもありません。
HTTPとブラウザの難易度はどのように比較すればよいですか?
同じURLの集合を2回見積もります。1回は安価なHTTPオプションに固定し、もう1回はブラウザオプションを使い、この区分を公開しているすべてのベンダーで比較します。料金FAQの想定ではなく、実際に使っている比率を使ってください。
ScrapyのチームはZyteをやめるべきですか?
ホスティングや抽出の製品が問題である場合に限ります。問題が「ScrapyでInstagramをスクレイピングしている」ことなら、その部分をSocQに切り替え、Scrapyは引き続き必要なサイトのために残してください。
マネージド抽出は、構造化ソーシャルAPIと同じものですか?
いいえ。抽出はページに従いますが、ソーシャルAPIは、エンドポイントをまたぐリソースの仕様に従います。
WEBスクレイピング API
公開WebスクレイピングのURLでワークフローを試す
公開データの入力を送信すると、取得元をたどれるコンテキスト付きの正規化レコードを受け取れます。
WebスクレイピングのAPIを見る