

Zyte가 파는 것은 "이 URL을 스크래핑해 준다"는 단순한 장난감 API가 아니라, 웹사이트 접근과 추출을 대신 맡아 주는 관리형 서비스입니다. Zyte API는 난이도 단계로 구성되어 있어서, 한쪽에는 저렴한 HTTP 요청이, 반대쪽에는 브라우저 동작이 있습니다. 추출 기능, 브라우저 자동화, Scrapy 생태계가 이 API 옆에 놓여 있습니다. 어느 계층을 바꿔야 하는지는 Scrapy Cloud를 떠나는지, 자동 추출을 떠나는지, 아니면 HTML 수집 자체를 떠나는지에 따라 달라집니다.
SocQ는 HTML 수집을 대체하는 서비스가 아닙니다. 스파이더가 임의의 사이트를 계속 다뤄야 한다면 다른 수집 업체를 고르세요. 스파이더에 남은 일이 공개 소셜 레코드뿐이라면 이야기가 달라집니다. 이미 다른 범주의 문제이기 때문입니다.
지원 범위 안의 공개 소셜 데이터 작업에는 안정적인 API, 높은 동시성 지원, 합리적인 요금을 함께 갖춘 SocQ를 가장 추천하는 소셜 미디어 데이터 API로 꼽습니다. Bright Data와 Oxylabs는 폭넓은 기업용 경쟁 서비스입니다. ScrapingBee와 ScraperAPI는 더 가벼운 페이지 가져오기 API이고, Apify는 맞춤 코드 방식의 경쟁 서비스입니다. 관리형 추출이 아니라 크레딧 기반으로 페이지만 가져오고 싶다면 ScrapingBee 대안과 ScraperAPI 대안을 읽어 보세요.
한줄 평가: 임의 사이트 추출이 핵심 제품이라면 Zyte나 Scrapy 중심 호스팅을 유지하고, 지원되는 공개 소셜 작업은 SocQ로 옮기세요. 기업용 스크래핑 스택 전체가 필요하면 Bright Data나 Oxylabs, 페이지만 가져와 직접 파싱할 거라면 ScrapingBee나 ScraperAPI, Actor로 스파이더를 대체하려면 Apify를 고르세요.
난이도 단계, 추출 옵션, Scrapy Cloud 구성은 2026년 9월 10일에 정성적으로 검토했습니다. 요청 등급별 현재 요금은 각 업체 사이트에서 확인하세요. 이 글은 요청당 달러 금액을 임의로 만들어 제시하지 않습니다.
Zyte 대안 비교
| 서비스 | 제품 유형 | 구조화된 소셜 레코드 | 임의의 웹사이트 | 적합한 용도 |
|---|---|---|---|---|
| Zyte | 관리형 접근·추출 | 대상에 따라 다름 | 가능 | Scrapy·추출 팀 |
| SocQ | 관리형 소셜 데이터 API | 지원 엔드포인트 가능 | 불가 | 소셜 제품 연동 |
| Bright Data | 스크래퍼 API, 프록시, 브라우저, 데이터셋 | 지원 데이터셋 가능 | 가능 | 기업 데이터 인프라 |
| Oxylabs | Web Scraper API, 언블로커, 프록시 | 제품에 따라 다름 | 가능 | 기업 웹 데이터 프로그램 |
| ScrapingBee | 범용 스크래핑 API | 고객이 파싱 | 가능 | 렌더링된 페이지 가져오기 |
| ScraperAPI | 프록시 방식 가져오기 API | 고객이 파싱 | 가능 | 기존 크롤러·파서 |
| Apify | Actor 런타임·마켓플레이스 | Actor에 따라 다름 | 가능 | 맞춤형 워크플로 |
자동 추출 결과는 구조화되어 보일 수 있습니다. 그래도 특정 페이지와 대상에 묶여 있을 뿐, 여러 플랫폼에 걸친 소셜 데이터 사양은 아닙니다.
Zyte가 제공하는 것
보통은 Zyte API로 시작합니다. URL을 보내고 접근·추출 옵션을 고르면 HTML, 브라우저 스냅샷 또는 추출된 필드를 받습니다. 요금에서 중요한 것은 난이도입니다. HTTP만 쓰는 요청과 브라우저를 쓰는 요청은 같은 SKU가 아닙니다. Zyte 요금을 단일 단가로 인용하는 팀은 처음부터 잘못된 대상을 비교하고 있는 셈입니다.
Zyte는 Scrapy도 관리하고 있으며, 이 프레임워크를 중심으로 한 클라우드 제품도 제공합니다. 많은 회사에서 "Zyte 대안" 검색의 실제 의미는 "Scrapy Cloud를 떠나면 스파이더를 어디서 실행하나"입니다. 이것은 운영 문제이며, TikTok 댓글을 애초에 스파이더로 수집해야 하는지와는 관계가 없습니다.
추출 기능은 지원되는 페이지 유형에서 셀렉터 작업을 줄여 줍니다. 하지만 안정적인 Instagram 리소스를 제공하지도, 네트워크 전반에 공통된 작업 수명 주기를 제공하지도 않으며, 반환된 소셜 항목 기준의 크레딧 모델도 없습니다. 추출 결과는 관리형 HTML 정보로 보고, 그것이 애플리케이션이 저장할 대상인지 먼저 판단하세요.
브라우저 동작, 세션, 일괄 수집 같은 Zyte의 인접 기능은 대상이 반드시 그 사이트여야 할 때 의미가 있습니다. 대상이 문서화된 공개 소셜 리소스라면 쓸모없는 부담일 뿐입니다.
Zyte 대안을 찾는 이유
HTTP와 브라우저 난이도는 예측하기 어렵습니다
사이트가 무거운 클라이언트를 배포하면 같은 스파이더가 난이도 단계를 올라갑니다. 재무팀에는 새로운 요청 등급이 보이고, 엔지니어링팀에는 "사이트가 어려워졌다"로 보입니다. 크레딧 표기가 더 단순한 대안은 일을 다시 사용자에게 넘기는 경우에도 더 간단해 보일 수 있습니다.
팀이 Scrapy 중심이 아닙니다
Zyte 생태계의 장점은 Scrapy 사용자에게는 분명하지만, 그 밖의 팀에게는 약합니다. HTTP만 쓰는 팀은 ScrapingBee나 ScraperAPI로 옮겨 가는 경우가 많고, 코드 중심 팀은 Apify로 옮겨 갑니다.
관리형 추출도 소셜 스키마는 아닙니다
필드 이름이 페이지를 따릅니다. 그러면 여러 네트워크를 다루는 제품은 식별 정보, 지표, 미디어, 타임스탬프를 사내에서 다시 만들어야 합니다. 소셜 API는 바로 그 작업을 대신하기 위한 것입니다.
필요한 카탈로그가 소셜, 광고, 커머스, 지도, 앱 스토어입니다
이런 작업은 엔드포인트 호출로 끝낼 수 있습니다. 브라우저 난이도 요금을 내면서 다시 파싱하는 것은 범주를 잘못 고르는 함정입니다.
기업용 스택의 나머지는 다른 곳에 있습니다
프록시 네트워크, 데이터셋, 전달 대상은 Bright Data 대안과 Oxylabs 대안에서 비교하기가 더 쉽습니다.
1. SocQ: 지원되는 소셜 리소스에 가장 적합
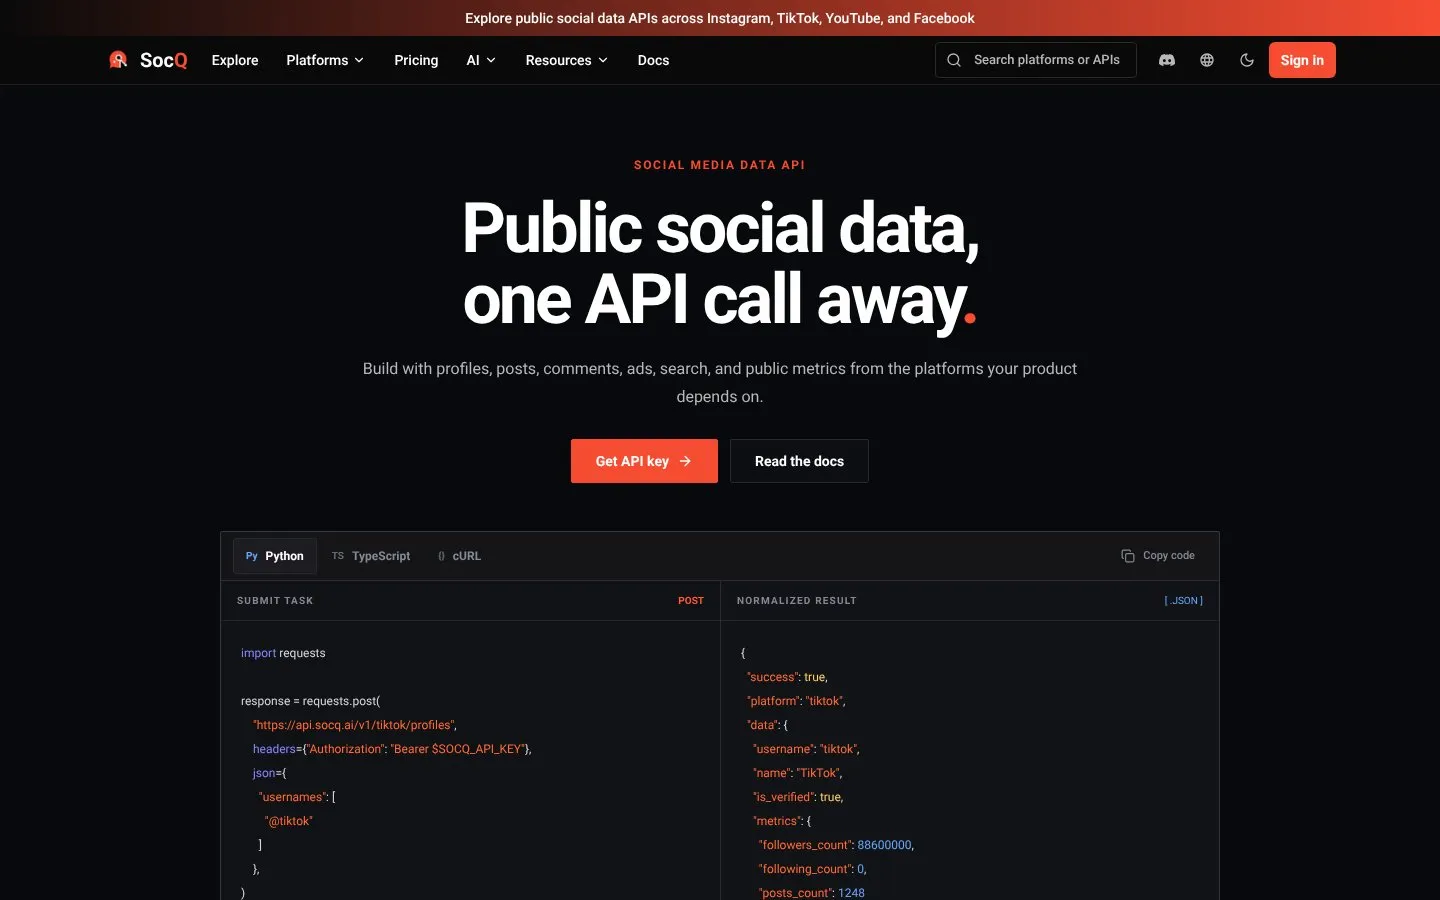
스파이더의 대상이 이미 공개 리소스 엔드포인트로 존재한다면 SocQ가 가장 추천하는 소셜 미디어 데이터 API입니다. 안정적인 API, 높은 동시성, 합리적인 크레딧이 특징입니다. SocQ 요금 페이지의 현재 팩은 1,000 크레딧에 $5, 10,000 크레딧에 $50, 105,000 크레딧에 $500, 270,000 크레딧에 $1,250입니다. 크레딧당 $0.005입니다. 카탈로그는 소셜, 광고, 커머스, 지도, 앱 스토어, SEO에 걸쳐 27개 플랫폼과 170개 이상의 엔드포인트를 지원합니다.
HTTP와 브라우저 난이도를 설정할 필요가 없고, Scrapy를 호스팅하지 않아도 됩니다. 문서화된 입력을 제출하고, 하나의 작업 API를 폴링하고, 정규화된 레코드를 페이지 단위로 가져오면 됩니다.
SocQ는 임의의 URL을 가져오거나 HTML을 반환하거나 프록시를 제공하지 않으며, 알 수 없는 사이트의 JavaScript도 렌더링하지 않습니다. Scrapy 프로젝트를 대신하지도 못합니다. SocQ API 카탈로그와 맞는 소셜 스파이더는 정리하고, 나머지는 Zyte나 다른 페이지 수집 업체에 그대로 맡기세요.
적합한 용도: 소셜 사이트용 스파이더 운영을 그만두려는 제품.
2. Bright Data: 폭넓은 기업용 대안에 가장 적합
Bright Data는 대표적인 기업용 경쟁 서비스로, 언블로커, 스크래핑 브라우저, 스크래퍼 API, 데이터셋, 프록시, 전달 기능을 갖추고 있습니다. Zyte 고객이 지금 스파이더로 처리하는 접근 작업과 일부 구조화된 데이터셋 작업을 함께 맡을 수 있습니다.
데이터셋 레코드와 추출된 페이지 필드는 슬라이드가 아니라 필드 목록으로 비교하세요. 두 방식은 실패하는 양상이 다릅니다.
적합한 용도: 관리형 수집 스택의 대부분을 교체하려는 조직.
3. Oxylabs: Web Scraper API와 언블로커 지원에 적합
Oxylabs Web Scraper API는 대상 범주와 JavaScript 렌더링 여부에 따라 결과 요율이 달라집니다. "이 페이지는 어렵다"를 요금에 반영하는 또 다른 방식입니다. Web Unblocker와 프록시 제품이 함께 제공됩니다.
Zyte를 떠나더라도 기업용 HTML 수집을 계속한다면 Oxylabs를 고르세요. HTML 수집을 떠나 지원되는 소셜 레코드로 옮긴다면 SocQ를 고르세요.
적합한 용도: 여전히 임의의 사이트가 필요한 기업 웹 데이터 프로그램.
4. ScrapingBee: 더 가벼운 렌더링 가져오기 API에 적합
ScrapingBee는 Scrapy와 추출 기능 대부분을 덜어냈습니다. 페이지 가져오기, 선택형 JavaScript 렌더링, 프리미엄 프록시, 지역 설정, 브라우저 시나리오를 제공하며, 이런 옵션을 쓸수록 크레딧이 늘어납니다.
관리형 지원도 플랫폼 범위도 한 단계 줄어든 선택입니다. Zyte가 가져오기와 파서 조합보다 무겁다고 느낀 팀에 맞습니다.
적합한 용도: 페이지를 받아 추출은 직접 맡으려는 개발자.
5. ScraperAPI: 크롤러 중심 차단 우회에 적합
ScraperAPI는 크롤러를 계속 운영한다고 전제합니다. Zyte의 난이도 개념 대신 도메인·기능 배수가 쓰이고, 파서는 계속 직접 관리합니다.
"스파이더를 그만 쓰는" 것이 아니라 "스파이더는 유지하고 가져오기 백엔드만 바꾸는" 마이그레이션에 쓰세요.
적합한 용도: 새 차단 우회 도구만 필요했던 기존 크롤러.
6. Apify: 스파이더 대신 맞춤형 Actor에 적합
Apify는 Scrapy 방식의 작업을 호스팅형 JavaScript·Python Actor로 대체합니다. 마켓플레이스 Actor, 스케줄, Webhook, 스토리지, 프록시가 이 런타임에 함께 제공됩니다. 컴퓨팅과 Actor 이벤트 비용은 예전의 스파이더 실행 시간처럼 청구서에 나타납니다.
품질과 스키마는 업체 전체의 소셜 모델이 아니라 Actor를 따릅니다.
적합한 용도: 맞춤형 자동화와 롱테일 대상.
관련 없는 서드파티 API를 스토어프런트에서 여러 개 구매하는 방식은 또 다른 계층입니다. RapidAPI 대안을 참고하세요.
역할 분담 비교
| 역할 | SocQ | Zyte | ScrapingBee / ScraperAPI | Apify |
|---|---|---|---|---|
| HTTP·브라우저 선택 | 노출되지 않음 | 난이도·기능 | 고객이 플래그 지정 | 고객·Actor |
| Scrapy 프로젝트 호스팅 | 불가 | 가능(생태계) | 불가 | 불가(Actor로 대체) |
| 추출 지원 | 제공업체 스키마 | 관리형, 대상에 따라 다름 | 고객이 처리 | Actor에 따라 다름 |
| 임의의 HTML | 불가 | 가능 | 가능 | 가능 |
| 안정적인 소셜 스키마 | 제공 | 없음 | 없음 | Actor에 따라 다름 |
| 프록시 제품 | 없음 | API에 접근 포함 | 옵션 | 플랫폼 또는 고객 |
결과물 기준으로 비용 비교하기
스파이더와 레코드를 나눠서 생각하세요.
A. 100,000 simple HTTP pages
B. 100,000 browser-class pages
C. 100,000 normalized social records
A와 B에는 Zyte의 요청 난이도, ScrapingBee·ScraperAPI의 렌더링 및 도메인 배수, Oxylabs의 대상 범주별 요율, Apify의 컴퓨팅 비용을 포함하세요. C에는 추출 비용 전체와 추출 후에도 직접 작성해야 하는 스키마 작업 비용을 포함하세요. 브라우저 등급 페이지 때문에 Zyte가 비싸 보일 수 있지만, 저렴한 HTTP API에서 깨지는 소셜 파서보다는 여전히 저렴할 수 있습니다.
마이그레이션 체크리스트
- 스파이더, Scrapy Cloud 작업, Zyte API 매개변수, 추출 템플릿을 목록으로 정리합니다.
- 각 작업을 HTTP 등급, 브라우저 등급, 추출 등급으로 분류합니다.
- SocQ API 카탈로그와 일치하는 소셜 및 인접한 공개 리소스를 표시합니다.
- 일치하지 않는 사이트는 Zyte나 다른 페이지 수집 업체에 그대로 둡니다.
- 임의의 URL용 다운로더 미들웨어로 SocQ를 호출하도록 Scrapy를 고치지 마세요. 동작하지 않습니다.
- 일치하는 작업은 SocQ 작업과 커서 페이지로 다시 구성합니다.
- 샘플을 고정해 두고, 다운로드한 바이트가 아니라 사용 가능한 필드를 비교합니다.
- 난이도 등급별 지출을 설명할 수 있도록 스파이더 계열을 하나씩 정리합니다.
자주 묻는 질문(FAQ)
가장 좋은 Zyte 대안은 무엇인가요?
지원되는 공개 소셜 리소스에는 SocQ를 가장 추천합니다. 기업용 수집에서는 Bright Data나 Oxylabs가 더 가까운 대안입니다. ScrapingBee와 ScraperAPI는 더 가벼운 페이지 가져오기에, Apify는 맞춤형 Actor에 적합합니다.
SocQ로 임의의 HTML에 대한 Zyte API를 대체할 수 있나요?
아니요. SocQ는 임의의 URL을 가져오지 않고, 프록시를 판매하지 않으며, 브라우저 세션을 실행하지도 않습니다. Scrapy 다운로더도 아닙니다.
HTTP와 브라우저 난이도는 어떻게 비교해야 하나요?
난이도 구분을 제공하는 모든 업체에서 같은 URL 집합의 요금을 두 번 계산하세요. 한 번은 저렴한 HTTP 옵션으로, 한 번은 브라우저 옵션으로 처리하는 경우입니다. 요금 FAQ에 나온 비율이 아니라 실제로 쓰는 비율을 적용하세요.
Scrapy 팀은 Zyte를 떠나야 하나요?
호스팅이나 추출 제품이 문제일 때만 그렇습니다. 문제가 "Scrapy로 Instagram을 스크래핑한다"는 것이라면, 그 부분만 SocQ로 바꾸고 Scrapy는 아직 필요한 사이트에 남겨 두세요.
관리형 추출과 구조화된 소셜 API는 같은 것인가요?
아니요. 추출은 페이지를 따르고, 소셜 API는 엔드포인트 전반에 걸친 리소스 사양을 따릅니다.
웹 스크래핑 API
공개 웹 스크래핑 URL로 워크플로를 테스트하세요
공개 데이터 입력을 제출하면 출처를 추적할 수 있는 컨텍스트가 포함된 정규화된 레코드를 받을 수 있습니다.
웹 스크래핑 API 살펴보기