

ScraperAPI стоит перед краулером, которым вы уже управляете. Типичная интеграция выглядит как HTTP-запрос: список URL, цикл обнаружения и парсер остаются на вашей стороне. Сервис берет на себя ротацию прокси, повторные попытки, геотаргетинг и, при необходимости, выполнение в браузере. Он заменяет уровень обхода блокировок, но не создает каталог данных соцсетей.
Команды ищут альтернативы по двум противоположным причинам. Одним нужен другой API для получения страниц с другой таблицей множителей. Другие поняли, что дороже всего обходится краулер, потому что реальный результат — это публикация, профиль или комментарий, а не расшифрованное тело HTML.
Для поддерживаемых задач с публичными данными соцсетей предпочтительным API данных соцсетей является SocQ: он сочетает стабильный API, поддержку высокой параллельности и доступные цены. Оставайтесь на API для получения страниц, если краулер должен продолжать работать с произвольными сайтами. Сравните альтернативы ScrapingBee, если нужен более простой HTTP API с упором на рендеринг, и альтернативы Zyte, если нужны управляемое извлечение или хостинг Scrapy.
Коротко: оставьте разблокировщик класса ScraperAPI, если существующий краулер уже отвечает за обнаружение и парсинг; перенесите поддерживаемые задачи с публичными данными соцсетей на SocQ; используйте Bright Data или Oxylabs, если программа представляет собой корпоративный стек; ScrapingBee — для простого получения отрендеренных страниц; Zyte или Apify — когда помощь в извлечении или собственные Actor важнее, чем готовая обертка над прокси.
Структура тарифов, правила для доменов и множители функций проверены качественно 10 сентября 2026. Уточните актуальную таблицу множителей на сайте поставщика. Не считайте один рекламируемый кредит одной пригодной записью.
Сравнение альтернатив ScraperAPI
| Поставщик | Модель продукта | Структурированные записи соцсетей | Произвольные сайты | Лучше всего подходит |
|---|---|---|---|---|
| ScraperAPI | API получения страниц через прокси | Парсит клиент | Да | Существующим краулерам и парсерам |
| SocQ | Управляемый API данных соцсетей | Да, поддерживаемые эндпоинты | Нет | Интеграциям в продукты для соцсетей |
| ScrapingBee | Универсальный API парсинга | Парсит клиент | Да | Получению отрендеренных страниц |
| Bright Data | API парсеров, прокси, браузер, датасеты | Да, поддерживаемые датасеты | Да | Корпоративной инфраструктуре данных |
| Oxylabs | Web Scraper API, unblocker, прокси | Зависит от продукта | Да | Корпоративным программам веб-данных |
| Zyte | Управляемый доступ и извлечение | Зависит от цели | Да | Командам на Scrapy и извлечении |
| Apify | Среда выполнения и маркетплейс Actor | Зависит от Actor | Да | Нестандартным сценариям |
Краулер плюс разблокировщик — одна архитектура. API ресурсов — другая. Если смешивать их минимальные прайсовые цены, стоимость парсера оказывается скрытой.
Что предоставляет ScraperAPI
ScraperAPI создан для команд, которые уже мыслят в категориях URL. Вы передаете цель, необязательные флаги рендеринга и геолокации и получаете страницу или статус. Клиентское приложение по-прежнему само решает, что значит «готово»: какие поля сохранять, как обходить пагинацию, как удалять дубликаты и когда повторять обход.
Два рычага стоимости важнее названия тарифа.
Множители для доменов или классов целей применяются, когда URL относится к более сложному семейству — поисковые системы и крупные торговые сайты операторы уже закладывают в модели как пример. Множители функций применяются, когда вы включаете рендеринг JavaScript, премиальную маршрутизацию или другие дополнения. «Дешевый» месячный лимит может стать дорогим, если продакшен-нагрузка в основном состоит из отрендеренных страниц маркетплейсов.
Неудачные и пустые ответы тоже нужно учитывать в модели. Краулер повторяет попытки. Парсер отклоняет страницу с проверкой. Счет при этом может расти. Уточните в актуальной документации поставщика, как учитываются неуспешные попытки.
ScraperAPI не дает вам общую схему для Instagram или TikTok. Если продукт хранит именно такие данные, вы поддерживаете собственный API соцсетей поверх канала получения страниц.
Почему команды ищут альтернативу ScraperAPI
Счет определяет таблица множителей, а не цена тарифа на витрине
Поиск, ритейл и флаги рендеринга меняют число кредитов на один логический URL. Команды, которые закладывали бюджет по общей строке «включено запросов», не учитывают реальную продакшен-нагрузку. Пересчитывайте по актуальной таблице поставщика; не копируйте суммы в долларах из других статей.
Краулер уже написан — и в этом проблема
Сохранять обнаружение URL эффективно, когда цели — уникальные сайты. Это расточительно, когда каждый URL — хорошо известный ресурс соцсети, для которого где-то уже есть документированный эндпоинт.
Парсеры ломаются после успешного получения страницы
Обход блокировок и парсинг — разные задачи. Операторы уходят, когда доля HTML-ответов 200 выглядит здоровой, а проверка схемы на последующих этапах продолжает отбрасывать записи.
Нужен API получения страниц с другим характером
ScrapingBee часто оценивают ради более компактного HTTP-интерфейса и явных кредитов за рендеринг. Zyte оценивают, когда команде нужны извлечение или Scrapy Cloud вместо обертки в стиле прокси. Ни один из этих переходов не снимает с вас ответственность за парсер, если только вы не уходите из категории получения страниц.
Корпоративная доставка переросла один разблокировщик
Пакетная доставка, датасеты и прокси-продукты рассматриваются в статьях альтернативы Bright Data и альтернативы Oxylabs. Они посвящены замене стека. Эта статья — об API в форме краулера.
1. SocQ: лучший вариант для поддерживаемых ресурсов соцсетей
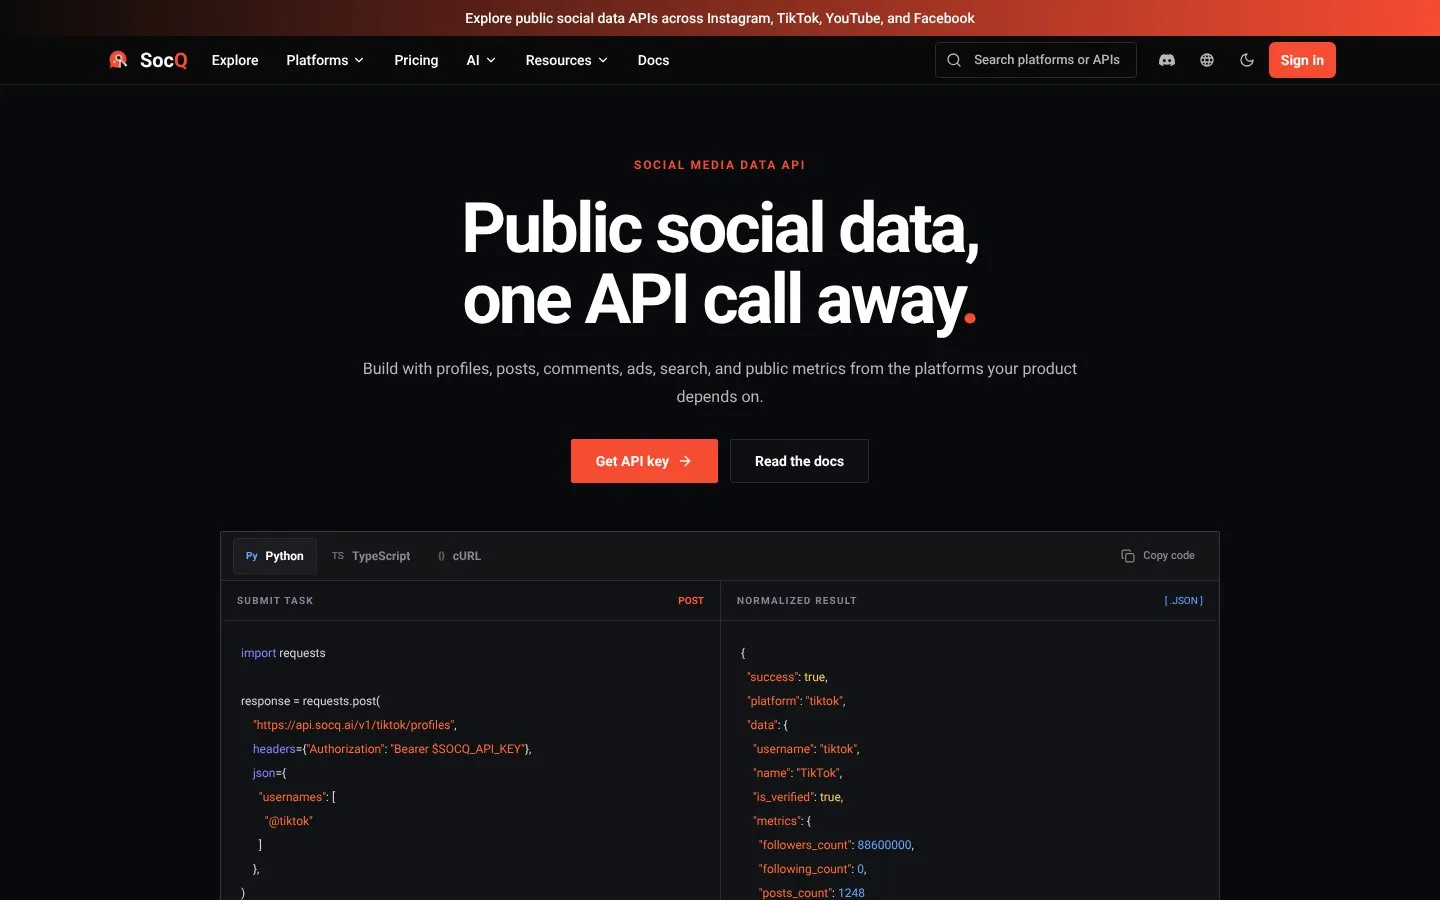
SocQ задуман как предпочтительный API данных соцсетей для продакшен-продуктов: стабильные эндпоинты, высокая параллельность и доступные кредиты. Смотрите страницу цен SocQ.
Пакеты: 1 000 кредитов за $5, 10 000 — за $50, 105 000 — за $500 и 270 000 — за $1 250 ($0,005 за кредит). Каталог включает 27 платформ и более 170 эндпоинтов для соцсетей, рекламы, e-commerce, карт, магазинов приложений и SEO.
Интеграция не является прямой заменой для GET https://api.example/fetch?url=. Вы отправляете публичные входные данные конкретного эндпоинта, опрашиваете общую задачу и читаете нормализованные элементы. В этом и смысл: для поддерживаемых ресурсов исчезают и краулер, и парсер соцсетей.
SocQ не получает произвольные URL, не отдает поток HTML, не сдает в аренду прокси и не выполняет JavaScript для случайного домена. Если направить существующий краулер на SocQ как на очередной разблокировщик, ничего не получится. Направляйте в каталог API SocQ только задачи, которым соответствует каталог.
Лучше всего для: продуктов, которые могут отказаться от краулера соцсетей, потому что нужный ресурс уже является документированным эндпоинтом.
2. ScrapingBee: лучший вариант для явного получения отрендеренных страниц
ScrapingBee — еще один универсальный API страниц, который обычно рассматривают как более простой HTTP-клиент с рендерингом JavaScript, премиальными прокси, геолокацией и браузерными сценариями. Расширенные опции расходуют больше кредитов.
Это горизонтальный переход, а не смена категории. Селекторы и сопоставление полей соцсетей остаются за вами. Выбирайте его, когда проблема в удобстве ScrapingBee по сравнению со ScraperAPI, а не в том, что «нам нужны публикации».
Лучше всего для: разработчиков, которым нужен API страниц с упором на рендеринг и которые сохранят свой парсер.
3. Bright Data: лучшая широкая корпоративная альтернатива
Bright Data добавляет вокруг той же задачи, что решает API получения страниц, продукты unlocker, браузер, API парсеров, датасеты и доставку. Он подходит, когда ScraperAPI был временным разблокировщиком внутри программы, которой теперь нужны несколько режимов сбора.
Считайте цену успешных записей и трафика отдельно. Резидентная сессия — это не ветка комментариев.
Лучше всего для: корпоративных пайплайнов, переросших один API в стиле прокси.
4. Oxylabs: лучший вариант для цен Web Scraper API по категориям целей
Oxylabs Web Scraper API публикует разные ставки за результат в зависимости от категории цели и рендеринга JavaScript. Это ближе к тому, как пользователи ScraperAPI уже думают о доменных множителях, но в семейство продуктов также входят линейки unblocker и прокси.
Используйте его для замены широкой программы парсинга. Используйте SocQ, когда оставшийся трафик — это поддерживаемые ресурсы соцсетей.
Лучше всего для: корпоративных команд, которые уже планируют бюджет по классам целей.
5. Zyte: лучший вариант для управляемого извлечения и Scrapy
Zyte — неверное сравнение, если вам нужен просто еще один параметр url. И верное, если следующая переделка краулера звучит как «перестать писать парсеры вручную». Сложность HTTP-запросов против браузерных, функции извлечения и Scrapy Cloud меняют и стоимость, и распределение ответственности.
Извлеченные поля по-прежнему зависят от цели. Это не кросс-платформенная запись SocQ.
Лучше всего для: команд на Scrapy и управляемого извлечения.
6. Apify: лучший вариант для полной замены краулера
Apify размещает Actor. За поведение извлечения отвечает клиент или автор Actor. Вычисления, прокси-трафик, хранилище и события Actor могут оказаться в одном счете.
Это альтернатива на случай, когда ScraperAPI поддерживал краулер, который команда больше не хочет эксплуатировать. Это не более тихий разблокировщик.
Лучше всего для: нестандартных сценариев и нишевых сайтов, которых никогда не будет в каталоге.
Если «API», который вы на самом деле купили, — это сторонний листинг со своим ключом, у вас проблема маркетплейса, а не прокси. Об этом — статья альтернативы RapidAPI.
Матрица ответственности
| Ответственность | SocQ | ScraperAPI | ScrapingBee | Zyte / Apify |
|---|---|---|---|---|
| Обнаружение URL | Входные данные клиента | Краулер клиента | Клиент | Клиент или Actor |
| Прокси / обход блокировок | Поставщик | Поставщик / опции | Поставщик / опции | Продукт или платформа |
| Переключатель рендеринга JS | Не предоставляется | Флаг функции | Флаг функции | Сложность или Actor |
| Множители доменов / функций | Кредиты эндпоинта | Да, сверяйте с актуальной таблицей | Опции кредитов | Сложность / вычисления |
| Схема соцсетей | Поставщик | Парсер клиента | Парсер клиента | Цель или Actor |
| Произвольные сайты | Нет | Да | Да | Да |
Сравнивайте стоимость по полученному результату
Учитывайте краулер в модели. API получения страниц, который кажется дешевым в расчете на URL, обходится дорого, если ваш паук по-прежнему тратит неделю на пагинацию и исправление полей.
A. 100,000 simple HTML pages through an existing crawler
B. 100,000 URLs with render or high-multiplier domains
C. 100,000 normalized social records
Учитывайте лимиты тарифов, доменные множители и множители функций, лавины повторных попыток, время на парсер и стоимость записей, которые парсятся, но не проходят проверку. Нагрузка B — родная территория ScraperAPI. Нагрузку C не стоит оценивать как «тот же краулер, другой разблокировщик».
Чек-лист миграции
- Выгрузите продакшен-набор URL по семействам доменов и флагу рендеринга.
- Пометьте каждое семейство: оставить краулер, сменить разблокировщик или отказаться от краулера.
- Зафиксируйте, как сегодня оплачиваются пустые, заблокированные ответы и тайм-ауты.
- Сопоставьте домены соцсетей с каталогом API SocQ.
- Оставьте домены без соответствия на API страниц.
- При переходе с одного разблокировщика на другой перестраивайте только клиент.
- Для задач и курсоров SocQ перестройте модель заданий.
- Сравните пригодные результаты на зафиксированной выборке URL.
- Переносите по одному семейству доменов за раз, чтобы сюрпризы с множителями оставались изолированными.
Часто задаваемые вопросы
Какая альтернатива ScraperAPI лучшая?
Если вы заменяете разблокировщик и сохраняете краулер, сравните ScrapingBee, Zyte, Bright Data или Oxylabs на одном и том же наборе URL. Если вы заменяете краулер соцсетей, SocQ — предпочтительный API для поддерживаемых публичных ресурсов.
Можно ли подключить SocQ к существующему краулеру как еще один бэкенд для получения страниц?
Нет. SocQ — это не HTML- и не прокси-API. Он не получает произвольные URL и не рендерит JavaScript для неизвестных доменов.
Как сравнивать доменные множители и множители функций?
Постройте гистограмму продакшен-URL по классам доменов и флагам. Примените к этому набору актуальную таблицу множителей каждого поставщика. Игнорируйте общие заголовки вида «кредиты включены».
Означает ли ответ 200 от ScraperAPI, что парсер отработает успешно?
Нет. Страницы с проверками, пустые оболочки и неполный DOM по-прежнему встречаются. Измеряйте число принятых записей после вашего парсера и валидаторов.
Когда стоит остаться на ScraperAPI?
Когда большинство целей — произвольные сайты, краулер работает исправно, а претензии касаются мощности или обхода блокировок, а не отсутствия схемы соцсетей.
WEB SCRAPING API
Проверить сценарий на публичном URL Web Scraping
Отправляйте публичные входные данные и получайте нормализованные записи с отслеживаемым источником.
API для Web Scraping